Vuex 是一个专为 Vue.js 应用程序开发的状态管理模式。它采用集中式存储管理应用的所有组件的状态,并以相应的规则保证状态以一种可预测的方式发生变化。Vuex 也集成到 Vue 的官方调试工具 devtools extension,提供了诸如零配置的 time-travel 调试、状态快照导入导出等高级调试功能。采用了全局单例模式,将组件的共享状态抽离出来管理,使得组件树中每一个位置都可以获取共享的状态或者触发行为。
那么什么是状态呢?我把状态理解为在没有使用vuex时,在当前组件中data内需要共用的数据为状态。
vuex使得状态或行为成为了共享的状态,所共享的状态或行为可以在各个组件中都可以访问到,省去了子父或子子之间传递变量,提高了开发效率。
当我们不使用vuex时,对于组件之间传递信息会较为麻烦。
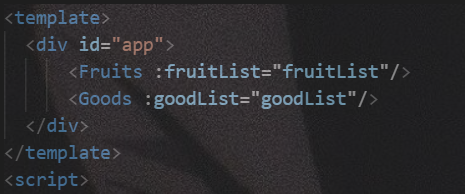
App.vue文件中:
<template>
  <div id="app">
      <Fruits :fruitList="fruitList"/>
  </div>
</template>
<script> import Goods from './components/Goods'; export default { name: 'App',
  components:{
    Fruits,
    Goods
  }, data(){
    return{ goodList:[
      {
        name:'doll',
        price:12 },
      { name:'glass',
        price:10 }
    ],
    }
  }
}
</script>
<style>
</style>
Good.vue文件中:
<template>
  <div class="hello">
      <ul>
        <li v-for="(good,index) in goodList" :key="index"> name:{{good.name}} number: {{good.number}} {{index}}
        </li>
      </ul>
  </div>
</template>

<script> export default { props:['goodList'],
}
</script>
<style>

</style>首先先创建一个js文件作为两兄弟之间传输的纽扣,这里起名为msg.js
//创建并暴露vue import Vue from 'vue';
export default new Vue
兄弟组件Goods:
<template>
  <div>
        <button @click="deliver">点击</button>
  </div>
</template>

<script> import MSG from '../msg';
export default {
  data(){ return{
      msg:'hahah' }
  },
  methods:{
    deliver() {
        MSG.$emit('showMsg',this.msg)
    }
  }

}
</script>
<style>

</style>
兄弟组件Fruits:
<template>
  <div>
      <div class="fruit">
          {{text}}
      </div>
  </div>
</template>
<script> import MSG from '../msg';
export default {
    data(){ return{
        text:'' }
    },
    created(){ this.getMsg()
    },
    methods:{
      getMsg(){
        MSG.$on('showMsg',(message)=>{ this.text = message
        })
      }
    }
}
</script>
<style>
</style>
在App组件中的代码:
点击按钮:
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
凡是要知其然知其所以然
文件上传相信很多朋友都有遇到过,那或许你也遇到过当上传大文件时,上传时间较长,且经常失败的困扰,并且失败后,又得重新上传很是烦人。那我们先了解下失败的原因吧!
据我了解大概有以下原因:
服务器配置:例如在PHP中默认的文件上传大小为8M【post_max_size = 8m】,若你在一个请求体中放入8M以上的内容时,便会出现异常
请求超时:当你设置了接口的超时时间为10s,那么上传大文件时,一个接口响应时间超过10s,那么便会被Faild掉。
网络波动:这个就属于不可控因素,也是较常见的问题。
基于以上原因,聪明的人们就想到了,将文件拆分多个小文件,依次上传,不就解决以上1,2问题嘛,这便是分片上传。 网络波动这个实在不可控,也许一阵大风刮来,就断网了呢。那这样好了,既然断网无法控制,那我可以控制只上传已经上传的文件内容,不就好了,这样大大加快了重新上传的速度。所以便有了“断点续传”一说。此时,人群中有人插了一嘴,有些文件我已经上传一遍了,为啥还要在上传,能不能不浪费我流量和时间。喔...这个嘛,简单,每次上传时判断下是否存在这个文件,若存在就不重新上传便可,于是又有了“秒传”一说。从此这"三兄弟" 便自行CP,统治了整个文件界。”
注意文中的代码并非实际代码,请移步至github查看代码
https://github.com/pseudo-god...
分片上传
HTML
原生INPUT样式较丑,这里通过样式叠加的方式,放一个Button.
<div class="btns">
<el-button-group>
<el-button :disabled="changeDisabled">
<i class="el-icon-upload2 el-icon--left" size="mini"></i>选择文件
<input
v-if="!changeDisabled"
type="file"
:multiple="multiple"
class="select-file-input"
:accept="accept"
@change="handleFileChange"
/>
</el-button>
<el-button :disabled="uploadDisabled" @click="handleUpload()"><i class="el-icon-upload el-icon--left" size="mini"></i>上传</el-button>
<el-button :disabled="pauseDisabled" @click="handlePause"><i class="el-icon-video-pause el-icon--left" size="mini"></i>暂停</el-button>
<el-button :disabled="resumeDisabled" @click="handleResume"><i class="el-icon-video-play el-icon--left" size="mini"></i>恢复</el-button>
<el-button :disabled="clearDisabled" @click="clearFiles"><i class="el-icon-video-play el-icon--left" size="mini"></i>清空</el-button>
</el-button-group>
<slot
//data 数据
var chunkSize = 10 * 1024 * 1024; // 切片大小
var fileIndex = 0; // 当前正在被遍历的文件下标
data: () => ({
container: {
files: null
},
tempFilesArr: [], // 存储files信息
cancels: [], // 存储要取消的请求
tempThreads: 3,
// 默认状态
status: Status.wait
}),
一个稍微好看的UI就出来了。
选择文件
选择文件过程中,需要对外暴露出几个钩子,熟悉elementUi的同学应该很眼熟,这几个钩子基本与其一致。onExceed:文件超出个数限制时的钩子、beforeUpload:文件上传之前
fileIndex 这个很重要,因为是多文件上传,所以定位当前正在被上传的文件就很重要,基本都靠它
handleFileChange(e) {
const files = e.target.files;
if (!files) return;
Object.assign(this.$data, this.$options.data()); // 重置data所有数据
fileIndex = 0; // 重置文件下标
this.container.files = files;
// 判断文件选择的个数
if (this.limit && this.container.files.length > this.limit) {
this.onExceed && this.onExceed(files);
return;
}
// 因filelist不可编辑,故拷贝filelist 对象
var index = 0; // 所选文件的下标,主要用于剔除文件后,原文件list与临时文件list不对应的情况
for (const key in this.container.files) {
if (this.container.files.hasOwnProperty(key)) {
const file = this.container.files[key];
if (this.beforeUpload) {
const before = this.beforeUpload(file);
if (before) {
this.pushTempFile(file, index);
}
}
if (!this.beforeUpload) {
this.pushTempFile(file, index);
}
index++;
}
}
},
// 存入 tempFilesArr,为了上面的钩子,所以将代码做了拆分
pushTempFile(file, index) {
// 额外的初始值
const obj = {
status: fileStatus.wait,
chunkList: [],
uploadProgress: 0,
hashProgress: 0,
index
};
for (const k in file) {
obj[k] = file[k];
}
console.log('pushTempFile -> obj', obj);
this.tempFilesArr.push(obj);
}
分片上传
创建切片,循环分解文件即可
createFileChunk(file, size = chunkSize) {
const fileChunkList = [];
var count = 0;
while (count < file.size) {
fileChunkList.push({
file: file.slice(count, count + size)
});
count += size;
}
return fileChunkList;
}
循环创建切片,既然咱们做的是多文件,所以这里就有循环去处理,依次创建文件切片,及切片的上传。
async handleUpload(resume) {
if (!this.container.files) return;
this.status = Status.uploading;
const filesArr = this.container.files;
var tempFilesArr = this.tempFilesArr;
for (let i = 0; i < tempFilesArr.length; i++) {
fileIndex = i;
//创建切片
const fileChunkList = this.createFileChunk(
filesArr[tempFilesArr[i].index]
);
tempFilesArr[i].fileHash ='xxxx'; // 先不用看这个,后面会讲,占个位置
tempFilesArr[i].chunkList = fileChunkList.map(({ file }, index) => ({
fileHash: tempFilesArr[i].hash,
fileName: tempFilesArr[i].name,
index,
hash: tempFilesArr[i].hash + '-' + index,
chunk: file,
size: file.size,
uploaded: false,
progress: 0, // 每个块的上传进度
status: 'wait' // 上传状态,用作进度状态显示
}));
//上传切片
await this.uploadChunks(this.tempFilesArr[i]);
}
}
上传切片,这个里需要考虑的问题较多,也算是核心吧,uploadChunks方法只负责构造传递给后端的数据,核心上传功能放到sendRequest方法中
async uploadChunks(data) {
var chunkData = data.chunkList;
const requestDataList = chunkData
.map(({ fileHash, chunk, fileName, index }) => {
const formData = new FormData();
formData.append('md5', fileHash);
formData.append('file', chunk);
formData.append('fileName', index); // 文件名使用切片的下标
return { formData, index, fileName };
});
try {
await this.sendRequest(requestDataList, chunkData);
} catch (error) {
// 上传有被reject的
this.$message.error('亲 上传失败了,考虑重试下呦' + error);
return;
}
// 合并切片
const isUpload = chunkData.some(item => item.uploaded === false);
console.log('created -> isUpload', isUpload);
if (isUpload) {
alert('存在失败的切片');
} else {
// 执行合并
await this.mergeRequest(data);
}
}
sendReques。上传这是最重要的地方,也是容易失败的地方,假设有10个分片,那我们若是直接发10个请求的话,很容易达到浏览器的瓶颈,所以需要对请求进行并发处理。
并发处理:这里我使用for循环控制并发的初始并发数,然后在 handler 函数里调用自己,这样就控制了并发。在handler中,通过数组API.shift模拟队列的效果,来上传切片。
重试: retryArr 数组存储每个切片文件请求的重试次数,做累加。比如[1,0,2],就是第0个文件切片报错1次,第2个报错2次。为保证能与文件做对应,const index = formInfo.index; 我们直接从数据中拿之前定义好的index。 若失败后,将失败的请求重新加入队列即可。
关于并发及重试我写了一个小Demo,若不理解可以自己在研究下,文件地址:https://github.com/pseudo-god... , 重试代码好像被我弄丢了,大家要是有需求,我再补吧!
// 并发处理
sendRequest(forms, chunkData) {
var finished = 0;
const total = forms.length;
const that = this;
const retryArr = []; // 数组存储每个文件hash请求的重试次数,做累加 比如[1,0,2],就是第0个文件切片报错1次,第2个报错2次
return new Promise((resolve, reject) => {
const handler = () => {
if (forms.length) {
// 出栈
const formInfo = forms.shift();
const formData = formInfo.formData;
const index = formInfo.index;
instance.post('fileChunk', formData, {
onUploadProgress: that.createProgresshandler(chunkData[index]),
cancelToken: new CancelToken(c => this.cancels.push(c)),
timeout: 0
}).then(res => {
console.log('handler -> res', res);
// 更改状态
chunkData[index].uploaded = true;
chunkData[index].status = 'success';
finished++;
handler();
})
.catch(e => {
// 若暂停,则禁止重试
if (this.status === Status.pause) return;
if (typeof retryArr[index] !== 'number') {
retryArr[index] = 0;
}
// 更新状态
chunkData[index].status = 'warning';
// 累加错误次数
retryArr[index]++;
// 重试3次
if (retryArr[index] >= this.chunkRetry) {
return reject('重试失败', retryArr);
}
this.tempThreads++; // 释放当前占用的通道
// 将失败的重新加入队列
forms.push(formInfo);
handler();
});
}
if (finished >= total) {
resolve('done');
}
};
// 控制并发
for (let i = 0; i < this.tempThreads; i++) {
handler();
}
});
}
切片的上传进度,通过axios的onUploadProgress事件,结合createProgresshandler方法进行维护
// 切片上传进度
createProgresshandler(item) {
return p => {
item.progress = parseInt(String((p.loaded / p.total) * 100));
this.fileProgress();
};
}
Hash计算
其实就是算一个文件的MD5值,MD5在整个项目中用到的地方也就几点。
秒传,需要通过MD5值判断文件是否已存在。
续传:需要用到MD5作为key值,当唯一值使用。
本项目主要使用worker处理,性能及速度都会有很大提升.
由于是多文件,所以HASH的计算进度也要体现在每个文件上,所以这里使用全局变量fileIndex来定位当前正在被上传的文件
执行计算hash
正在上传文件
// 生成文件 hash(web-worker)
calculateHash(fileChunkList) {
return new Promise(resolve => {
this.container.worker = new Worker('./hash.js');
this.container.worker.postMessage({ fileChunkList });
this.container.worker.onmessage = e => {
const { percentage, hash } = e.data;
if (this.tempFilesArr[fileIndex]) {
this.tempFilesArr[fileIndex].hashProgress = Number(
percentage.toFixed(0)
);
}
if (hash) {
resolve(hash);
}
};
});
}
因使用worker,所以我们不能直接使用NPM包方式使用MD5。需要单独去下载spark-md5.js文件,并引入
//hash.js
self.importScripts("/spark-md5.min.js"); // 导入脚本
// 生成文件 hash
self.onmessage = e => {
const { fileChunkList } = e.data;
const spark = new self.SparkMD5.ArrayBuffer();
let percentage = 0;
let count = 0;
const loadNext = index => {
const reader = new FileReader();
reader.readAsArrayBuffer(fileChunkList[index].file);
reader.onload = e => {
count++;
spark.append(e.target.result);
if (count === fileChunkList.length) {
self.postMessage({
percentage: 100,
hash: spark.end()
});
self.close();
} else {
percentage += 100 / fileChunkList.length;
self.postMessage({
percentage
});
loadNext(count);
}
};
};
loadNext(0);
};
文件合并
当我们的切片全部上传完毕后,就需要进行文件的合并,这里我们只需要请求接口即可
mergeRequest(data) {
const obj = {
md5: data.fileHash,
fileName: data.name,
fileChunkNum: data.chunkList.length
};
instance.post('fileChunk/merge', obj,
{
timeout: 0
})
.then((res) => {
this.$message.success('上传成功');
});
}
Done: 至此一个分片上传的功能便已完成
断点续传
顾名思义,就是从那断的就从那开始,明确思路就很简单了。一般有2种方式,一种为服务器端返回,告知我从那开始,还有一种是浏览器端自行处理。2种方案各有优缺点。本项目使用第二种。
思路:已文件HASH为key值,每个切片上传成功后,记录下来便可。若需要续传时,直接跳过记录中已存在的便可。本项目将使用Localstorage进行存储,这里我已提前封装好addChunkStorage、getChunkStorage方法。
存储在Stroage的数据
缓存处理
在切片上传的axios成功回调中,存储已上传成功的切片
instance.post('fileChunk', formData, )
.then(res => {
// 存储已上传的切片下标
+ this.addChunkStorage(chunkData[index].fileHash, index);
handler();
})
在切片上传前,先看下localstorage中是否存在已上传的切片,并修改uploaded
async handleUpload(resume) {
+ const getChunkStorage = this.getChunkStorage(tempFilesArr[i].hash);
tempFilesArr[i].chunkList = fileChunkList.map(({ file }, index) => ({
+ uploaded: getChunkStorage && getChunkStorage.includes(index), // 标识:是否已完成上传
+ progress: getChunkStorage && getChunkStorage.includes(index) ? 100 : 0,
+ status: getChunkStorage && getChunkStorage.includes(index)? 'success'
+ : 'wait' // 上传状态,用作进度状态显示
}));
}
构造切片数据时,过滤掉uploaded为true的
async uploadChunks(data) {
var chunkData = data.chunkList;
const requestDataList = chunkData
+ .filter(({ uploaded }) => !uploaded)
.map(({ fileHash, chunk, fileName, index }) => {
const formData = new FormData();
formData.append('md5', fileHash);
formData.append('file', chunk);
formData.append('fileName', index); // 文件名使用切片的下标
return { formData, index, fileName };
})
}
垃圾文件清理
随着上传文件的增多,相应的垃圾文件也会增多,比如有些时候上传一半就不再继续,或上传失败,碎片文件就会增多。解决方案我目前想了2种
前端在localstorage设置缓存时间,超过时间就发送请求通知后端清理碎片文件,同时前端也要清理缓存。
前后端都约定好,每个缓存从生成开始,只能存储12小时,12小时后自动清理
以上2中方案似乎都有点问题,极有可能造成前后端因时间差,引发切片上传异常的问题,后面想到合适的解决方案再来更新吧。
Done: 续传到这里也就完成了。
秒传
这算是最简单的,只是听起来很厉害的样子。原理:计算整个文件的HASH,在执行上传操作前,向服务端发送请求,传递MD5值,后端进行文件检索。若服务器中已存在该文件,便不进行后续的任何操作,上传也便直接结束。大家一看就明白
async handleUpload(resume) {
if (!this.container.files) return;
const filesArr = this.container.files;
var tempFilesArr = this.tempFilesArr;
for (let i = 0; i < tempFilesArr.length; i++) {
const fileChunkList = this.createFileChunk(
filesArr[tempFilesArr[i].index]
);
// hash校验,是否为秒传
+ tempFilesArr[i].hash = await this.calculateHash(fileChunkList);
+ const verifyRes = await this.verifyUpload(
+ tempFilesArr[i].name,
+ tempFilesArr[i].hash
+ );
+ if (verifyRes.data.presence) {
+ tempFilesArr[i].status = fileStatus.secondPass;
+ tempFilesArr[i].uploadProgress = 100;
+ } else {
console.log('开始上传切片文件----》', tempFilesArr[i].name);
await this.uploadChunks(this.tempFilesArr[i]);
}
}
}
// 文件上传之前的校验: 校验文件是否已存在
verifyUpload(fileName, fileHash) {
return new Promise(resolve => {
const obj = {
md5: fileHash,
fileName,
...this.uploadArguments //传递其他参数
};
instance
.post('fileChunk/presence', obj)
.then(res => {
resolve(res.data);
})
.catch(err => {
console.log('verifyUpload -> err', err);
});
});
}
Done: 秒传到这里也就完成了。
后端处理
文章好像有点长了,具体代码逻辑就先不贴了,除非有人留言要求,嘻嘻,有时间再更新
Node版
请前往 https://github.com/pseudo-god... 查看
JAVA版
下周应该会更新处理
PHP版
1年多没写PHP了,抽空我会慢慢补上来
待完善
切片的大小:这个后面会做出动态计算的。需要根据当前所上传文件的大小,自动计算合适的切片大小。避免出现切片过多的情况。
文件追加:目前上传文件过程中,不能继续选择文件加入队列。(这个没想好应该怎么处理。)
更新记录
组件已经运行一段时间了,期间也测试出几个问题,本来以为没BUG的,看起来BUG都挺严重
BUG-1:当同时上传多个内容相同但是文件名称不同的文件时,出现上传失败的问题。
预期结果:第一个上传成功后,后面相同的问文件应该直接秒传
实际结果:第一个上传成功后,其余相同的文件都失败,错误信息,块数不对。
原因:当第一个文件块上传完毕后,便立即进行了下一个文件的循环,导致无法及时获取文件是否已秒传的状态,从而导致失败。
解决方案:在当前文件分片上传完毕并且请求合并接口完毕后,再进行下一次循环。
将子方法都改为同步方式,mergeRequest 和 uploadChunks 方法
BUG-2: 当每次选择相同的文件并触发beforeUpload方法时,若第二次也选择了相同的文件,beforeUpload方法失效,从而导致整个流程失效。
原因:之前每次选择文件时,没有清空上次所选input文件的数据,相同数据的情况下,是不会触发input的change事件。
解决方案:每次点击input时,清空数据即可。我顺带优化了下其他的代码,具体看提交记录吧。
<input
v-if="!changeDisabled"
type="file"
:multiple="multiple"
class="select-file-input"
:accept="accept"
+ οnclick="f.outerHTML=f.outerHTML"
@change="handleFileChange"/>
重写了暂停和恢复的功能,实际上,主要是增加了暂停和恢复的状态
之前的处理逻辑太简单粗暴,存在诸多问题。现在将状态定位在每一个文件之上,这样恢复上传时,直接跳过即可
封装组件
写了一大堆,其实以上代码你直接复制也无法使用,这里我将此封装了一个组件。大家可以去github下载文件,里面有使用案例 ,若有用记得随手给个star,谢谢!
偷个懒,具体封装组件的代码就不列出来了,大家直接去下载文件查看,若有不明白的,可留言。
组件文档
Attribute
参数 类型 说明 默认 备注
headers Object 设置请求头
before-upload Function 上传文件前的钩子,返回false则停止上传
accept String 接受上传的文件类型
upload-arguments Object 上传文件时携带的参数
with-credentials Boolean 是否传递Cookie false
limit Number 最大允许上传个数 0 0为不限制
on-exceed Function 文件超出个数限制时的钩子
multiple Boolean 是否为多选模式 true
base-url String 由于本组件为内置的AXIOS,若你需要走代理,可以直接在这里配置你的基础路径
chunk-size Number 每个切片的大小 10M
threads Number 请求的并发数 3 并发数越高,对服务器的性能要求越高,尽可能用默认值即可
chunk-retry Number 错误重试次数 3 分片请求的错误重试次数
Slot
方法名 说明 参数 备注
header 按钮区域 无
tip 提示说明文字 无
后端接口文档:按文档实现即可
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
我们应该学习 webpack 吗 ?
如今,CLI工具(如create-react-app或Vue -cli)已经为我们抽象了大部分配置,并提供了合理的默认设置。
即使那样,了解幕后工作原理还是有好处的,因为我们迟早需要对默认值进行一些调整。
在本文中中,我们会知道 webpack可以做什么,以及如何配置它以满足我们的日常需求。
什么是 webpack?
作为前端开发人员,我们应该熟悉 module 概念。 你可能听说过 AMD模块,UMD,Common JS还有ES模块。
webpack是一个模块绑定器,它对模块有一个更广泛的定义,对于webpack来说,模块是:
Common JS modules
AMD modules
CSS import
Images url
ES modules
webpack 还可以从这些模块中获取依赖关系。
webpack 的最终目标是将所有这些不同的源和模块类型统一起来,从而将所有内容导入JavaScript代码,并最生成可以运行的代码。
entry
Webpack的 entry(入口点)是收集前端项目的所有依赖项的起点。 实际上,这是一个简单的 JavaScript 文件。
这些依赖关系形成一个依赖关系图。
Webpack 的默认入口点(从版本4开始)是src/index.js,它是可配置的。 webpack 可以有多个入口点。
Output
output是生成的JavaScript和静态文件的地方。
Loaders
Loaders 是第三方扩展程序,可帮助webpack处理各种文件扩展名。 例如,CSS,图像或txt文件。
Loaders的目标是在模块中转换文件(JavaScript以外的文件)。 文件成为模块后,webpack可以将其用作项目中的依赖项。
Plugins
插件是第三方扩展,可以更改webpack的工作方式。 例如,有一些用于提取HTML,CSS或设置环境变量的插件。
Mode
webpack 有两种操作模式:开发(development)和生产(production)。 它们之间的主要区别是生产模式自动生成一些优化后的代码。
Code splitting
代码拆分或延迟加载是一种避免生成较大包的优化技术。
通过代码拆分,开发人员可以决定仅在响应某些用户交互时加载整个JavaScript块,比如单击或路由更改(或其他条件)。
被拆分的一段代码称为 chunk。
Webpack入门
开始使用webpack时,先创建一个新文件夹,然后进入该文件中,初始化一个NPM项目,如下所示:
mkdir webpack-tutorial && cd $_
npm init -y
接着安装 webpack,webpack-cli和 webpack-dev-server:
npm i webpack webpack-cli webpack-dev-server --save-dev
要运行 webpack,只需要在 package.json 配置如下命令即可:
"scripts": {
"dev": "webpack --mode development"
},
通过这个脚本,我们指导webpack在开发模式下工作,方便在本地工作。
Webpack 的第一步
在开发模式下运行 webpack:
npm run dev
运行完后会看到如下错误:
ERROR in Entry module not found: Error: Can't resolve './src'
webpack 在这里寻找默认入口点src/index.js,所以我们需要手动创建一下,并输入一些内容:
mkdir src
echo 'console.log("Hello webpack!")' > src/index.js
现在再次运行npm run dev,错误就没有了。 运行的结果生成了一个名为dist/的新文件夹,其中包含一个名为main.js的 JS 文件:
dist
└── main.js
这是我们的第一个webpack包,也称为output。
配置 Webpack
对于简单的任务,webpack无需配置即可工作,但是很快我们就会遇到问题,一些文件如果没有指定的 loader 是没法打包的。所以,我们需要对 webpack进行配置,对于 webpack 的配置是在 webpack.config.js 进行的,所以我们需要创建该文件:
touch webpack.config.js
Webpack 用 JavaScript 编写,并在无头 JS 环境(例如Node.js)上运行。 在此文件中,至少需要一个module.exports,这是的 Common JS 导出方式:
module.exports = {
//
};
在webpack.config.js中,我们可以通过添加或修改来改变webpack的行为方式
entry point
output
loaders
plugins
code splitting
例如,要更改入口路径,我们可以这样做
const path = require("path");
module.exports = {
entry: { index: path.resolve(__dirname, "source", "index.js") }
};
现在,webpack 将在source/index.js中查找要加载的第一个文件。 要更改包的输出路径,我们可以这样做:
const path = require("path");
module.exports = {
output: {
path: path.resolve(__dirname, "build")
}
}
这样,webpack将把最终生成包放在build中,而不是dist.(为了简单起见,在本文中,我们使用默认配置)。
打包 HTML
没有HTML页面的Web应用程序几乎没有用。 要在webpack中使用 HTML,我们需要安装一个插件html-webpack-plugin:
npm i html-webpack-plugin --save-dev
一旦插件安装好,我们就可以对其进行配置:
const HtmlWebpackPlugin = require("html-webpack-plugin");
const path = require("path");
module.exports = {
plugins: [
new HtmlWebpackPlugin({
template: path.resolve(__dirname, "src", "index.html")
})
]
};
这里的意思是让 webpack,从 src/index.html 加载 HTML 模板。
html-webpack-plugin的最终目标有两个:
加载 html 文件
它将bundle注入到同一个文件中
接着,我们需要在 src/index.html 中创建一个简单的 HTML 文件:
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<title>Webpack tutorial</title>
</head>
<body>
</body>
</html>
稍后,我们会运行这个程序。
webpack development server
在本文第一部分中,我们安装了webpack-dev-server。如果你忘记安装了,现在可以运行下面命令安装一下:
npm i webpack-dev-server --save-dev
webpack-dev-server 可以让开发更方便,不需要改动了文件就去手动刷新文件。 配置完成后,我们可以启动本地服务器来提供文件。
要配置webpack-dev-server,请打开package.json并添加一个 “start” 命令:
"scripts": {
"dev": "webpack --mode development",
"start": "webpack-dev-server --mode development --open",
},
有了 start 命令,我们来跑一下:
npm start
运行后,默认浏览器应打开。 在浏览器的控制台中,还应该看到一个 script 标签,引入的是我们的 main.js。
clipboard.png
使用 webpack loader
Loader是第三方扩展程序,可帮助webpack处理各种文件扩展名。 例如,有用于 CSS,图像或 txt 文件的加载程序。
下面是一些 loader 配置介绍:
module.exports = {
module: {
rules: [
{
test: /\.filename$/,
use: ["loader-b", "loader-a"]
}
]
},
//
};
相关配置以module 关键字开始。 在module内,我们在rules内配置每个加载程序组或单个加载程序。
对于我们想要作为模块处理的每个文件,我们用test和use配置一个对象
{
test: /\.filename$/,
use: ["loader-b", "loader-a"]
}
test 告诉 webpack “嘿,将此文件名视为一个模块”。 use 定义将哪些 loaders 应用于些打包的文件。
打包 CSS
要 在webpack 中打包CSS,我们需要至少安装两个 loader。Loader 对于帮助 webpack 了解如何处理.css文件是必不可少的。
要在 webpack 中测试 CSS,我们需要在 src 下创建一个style.css文件:
h1 {
color: orange;
}
另外在 src/index.html 添加 h1 标签
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<title>Webpack tutorial</title>
</head>
<body>
<h1>Hello webpack!</h1>
</body>
</html>
最后,在src/index.js 中加载 CSS:
在测试之前,我们需要安装两个 loader:
css-loader: 解析 css 代码中的 url、@import语法像import和require一样去处理css里面引入的模块
style-loader:帮我们直接将css-loader解析后的内容挂载到html页面当中
安装 loader:
npm i css-loader style-loader --save-dev
然后在webpack.config.js中配置它们
const HtmlWebpackPlugin = require("html-webpack-plugin");
const path = require("path");
module.exports = {
module: {
rules: [
{
test: /\.css$/,
use: ["style-loader", "css-loader"]
}
]
},
plugins: [
new HtmlWebpackPlugin({
template: path.resolve(__dirname, "src", "index.html")
})
]
};
现在,如果你运行npm start,会看到样式表加载在HTML的头部:
clipboard.png
一旦CSS Loader 就位,我们还可以使用MiniCssExtractPlugin提取CSS文件
Webpack Loader 顺序很重要!
在webpack中,Loader 在配置中出现的顺序非常重要。以下配置无效:
//
module.exports = {
module: {
rules: [
{
test: /\.css$/,
use: ["css-loader", "style-loader"]
}
]
},
//
};
此处,“style-loader”出现在 “css-loader” 之前。 但是style-loader用于在页面中注入样式,而不是用于加载实际的CSS文件。
相反,以下配置有效:
module.exports = {
module: {
rules: [
{
test: /\.css$/,
use: ["style-loader", "css-loader"]
}
]
},
//
};
webpack loaders 是从右到左执行的。
打包 sass
要在 webpack 中测试sass,同样,我们需要在 src 目录下创建一个 style.scss 文件:
@import url("https://fonts.googleapis.com/css?family=Karla:weight@400;700&display=swap");
$font: "Karla", sans-serif;
$primary-color: #3e6f9e;
body {
font-family: $font;
color: $primary-color;
}
另外,在src/index.html中添加一些 Dom 元素:
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<title>Webpack tutorial</title>
</head>
<body>
<h1>Hello webpack!</h1>
<p>Hello sass!</p>
</body>
</html>
最后,将 sass 文件加载到src/index.js中:
import "./style.scss";
console.log("Hello webpack!");
在测试之前,我们需要安装几个 loader:
sass-loader:加载 SASS / SCSS 文件并将其编译为 CSS
css-loader: 解析 css 代码中的 url、@import语法像import和require一样去处理css里面引入的模块
style-loader:帮我们直接将css-loader解析后的内容挂载到html页面当中
安装 loader:
npm i css-loader style-loader sass-loader sass --save-dev
然后在webpack.config.js中配置它们:
const HtmlWebpackPlugin = require("html-webpack-plugin");
const path = require("path");
module.exports = {
module: {
rules: [
{
test: /\.scss$/,
use: ["style-loader", "css-loader", "sass-loader"]
}
]
},
plugins: [
new HtmlWebpackPlugin({
template: path.resolve(__dirname, "src", "index.html")
})
]
};
注意loader的出现顺序:首先是sass-loader,然后是css-loader,最后是style-loader。
现在,运行npm start,你应该会在HTML的头部看到加载的样式表:
clipboard.png
打包现代 JavaScrip
webpack 本身并不知道如何转换JavaScript代码。 该任务已外包给babel的第三方 loader,特别是babel-loader。
babel是一个JavaScript编译器和“编译器”。 babel 可以将现代JS(es6, es7...)转换为可以在(几乎)任何浏览器中运行的兼容代码。
同样,要使用它,我们需要安装一些 Loader:
babel-core :把 js 代码分析成 ast ,方便各个插件分析语法进行相应的处理
babel-preset-env:将现代 JS 编译为ES5
babel-loader :用于 webpack
引入依赖关系
npm i @babel/core babel-loader @babel/preset-env --save-dev
接着,创建一个新文件babel.config.json配置babel,内容如下:
{
"presets": [
"@babel/preset-env"
]
}
最后在配置一下 webpack :
const HtmlWebpackPlugin = require("html-webpack-plugin");
const path = require("path");
module.exports = {
module: {
rules: [
{
test: /\.scss$/,
use: ["style-loader", "css-loader", "sass-loader"]
},
{
test: /\.js$/,
exclude: /node_modules/,
use: ["babel-loader"]
}
]
},
plugins: [
new HtmlWebpackPlugin({
template: path.resolve(__dirname, "src", "index.html")
})
]
};
要测试转换,可以在 src/index.js中编写一些现代语法:
import "./style.scss";
console.log("Hello webpack!");
const fancyFunc = () => {
return [1, 2];
};
const [a, b] = fancyFunc();
现在运行npm run dev来查看dist中转换后的代码。 打开 dist/main.js并搜索“fancyFunc”:
\n\nvar fancyFunc = function fancyFunc() {\n return [1, 2];\n};\n\nvar _fancyFunc = fancyFunc(),\n _fancyFunc2 = _slicedToArray(_fancyFunc, 2),\n a = _fancyFunc2[0],\n b = _fancyFunc2[1];\n\n//# sourceURL=webpack:///./src/index.js?"
没有babel,代码将不会被转译:
\n\nconsole.log(\"Hello webpack!\");\n\nconst fancyFunc = () => {\n return [1, 2];\n};\n\nconst [a, b] = fancyFunc();\n\n\n//# sourceURL=webpack:///./src/index.js?");
注意:即使没有babel,webpack也可以正常工作。 仅在执行 ES5 代码时才需要进行代码转换过程。
在 Webpack 中使用 JS 的模块
webpack 将整个文件视为模块。 但是,请不要忘记它的主要目的:加载ES模块。
ECMAScript模块(简称ES模块)是一种JavaScript代码重用的机制,于2015年推出,一经推出就受到前端开发者的喜爱。在2015之年,JavaScript 还没有一个代码重用的标准机制。多年来,人们对这方面的规范进行了很多尝试,导致现在有多种模块化的方式。
你可能听说过AMD模块,UMD,或CommonJS,这些没有孰优孰劣。最后,在ECMAScript 2015中,ES 模块出现了。
我们现在有了一个“正式的”模块系统。
要在 webpack 使用 ES module ,首先创建 src/common/usersAPI.js 文件:
const ENDPOINT = "https://jsonplaceholder.typicode.com/users/";
export function getUsers() {
return fetch(ENDPOINT)
.then(response => {
if (!response.ok) throw Error(response.statusText);
return response.json();
})
.then(json => json);
}
在 src/index.js中,引入上面的模块:
import { getUsers } from "./common/usersAPI";
import "./style.scss";
console.log("Hello webpack!");
getUsers().then(json => console.log(json));
生产方式
如前所述,webpack有两种操作模式:开发(development )和(production)。 到目前为止,我们仅在开发模式下工作。
在开发模式中,为了便于代码调试方便我们快速定位错误,不会压缩混淆源代码。相反,在生产模式下,webpac k进行了许多优化:
使用 TerserWebpackPlugin 进行缩小以减小 bundle 的大小
使用ModuleConcatenationPlugin提升作用域
在生产模式下配 置webpack,请打开 package.json 并添加一个“ build” 命令:
现在运行 npm run build,webpack 会生成一个压缩的包。
Code splitting
代码拆分(Code splitting)是指针对以下方面的优化技术:
避免出现一个很大的 bundle
避免重复的依赖关系
webpack 社区考虑到应用程序的初始 bundle 的最大大小有一个限制:200KB。
在 webpack 中有三种激活 code splitting 的主要方法:
有多个入口点
使用 optimization.splitChunks 选项
动态导入
第一种基于多个入口点的技术适用于较小的项目,但是从长远来看它是不可扩展的。这里我们只关注第二和第三种方式。
Code splitting 与 optimization.splitChunks
考虑一个使用Moment.js 的 JS 应用程序,Moment.js是流行的时间和日期JS库。
在项目文件夹中安装该库:
npm i moment
现在清除src/index.js的内容,并引入 moment 库:
import moment from "moment";
运行 npm run build 并查看控制的输出内容:
main.js 350 KiB 0 [emitted] [big] main
整个 moment 库都绑定到了 main.js 中这样是不好的。借助optimization.splitChunks,我们可以从主包中移出moment.js。
要使用它,需要在 webpack.config.js 添加 optimization 选项:
const HtmlWebpackPlugin = require("html-webpack-plugin");
const path = require("path");
module.exports = {
module: {
// ...
},
optimization: {
splitChunks: { chunks: "all" }
},
// ...
};
运行npm run build 并查看运行结果:
main.js 5.05 KiB 0 [emitted] main
vendors~main.js 346 KiB 1 [emitted] [big] vendors~main
现在,我们有了一个带有moment.js 的vendors〜main.js,而主入口点的大小更合理。
注意:即使进行代码拆分,moment.js仍然是一个体积较大的库。 有更好的选择,如使用luxon或date-fns。
Code splitting 与 动态导入
Code splitting的一种更强大的技术使用动态导入来有条件地加载代码。 在ECMAScript 2020中提供此功能之前,webpack 提供了动态导入。
这种方法在 Vue 和 React 之类的现代前端库中得到了广泛使用(React有其自己的方式,但是概念是相同的)。
Code splitting 可用于:
模块级别
路由级别
例如,你可以有条件地加载一些 JavaScript 模块,以响应用户的交互(例如单击或鼠标移动)。 或者,可以在响应路由更改时加载代码的相关部分。
要使用动态导入,我们先清除src/index.html,并写入下面的内容:
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<title>Dynamic imports</title>
</head>
<body>
<button id="btn">Load!</button>
</body>
</html>
在 src/common/usersAPI.js中:
const ENDPOINT = "https://jsonplaceholder.typicode.com/users/";
export function getUsers() {
return fetch(ENDPOINT)
.then(response => {
if (!response.ok) throw Error(response.statusText);
return response.json();
})
.then(json => json);
}
在 src/index.js 中
const btn = document.getElementById("btn");
btn.addEventListener("click", () => {
//
});
如果运行npm run start查看并单击界面中的按钮,什么也不会发生。
现在想象一下,我们想在某人单击按钮后加载用户列表。 “原生”的方法可以使用静态导入从src/common /usersAPI.js加载函数:
import { getUsers } from "./common/usersAPI";
const btn = document.getElementById("btn");
btn.addEventListener("click", () => {
getUsers().then(json => console.log(json));
});
问题在于ES模块是静态的,这意味着我们无法在运行时更改导入的内容。
通过动态导入,我们可以选择何时加载代码
const getUserModule = () => import("./common/usersAPI");
const btn = document.getElementById("btn");
btn.addEventListener("click", () => {
getUserModule().then(({ getUsers }) => {
getUsers().then(json => console.log(json));
});
});
这里我们创建一个函数来动态加载模块
const getUserModule = () => import("./common/usersAPI");
现在,当你第一次使用npm run start加载页面时,会看到控制台中已加载 js 包:
clipboard.png
现在,仅在单击按钮时才加载/common/usersAPI:
clipboard.png
对应的 chunk 是 0.js
通过在导入路径前面加上魔法注释/ * webpackChunkName:“ name_here” * /,可以更改块名称:
const getUserModule = () =>
import(/* webpackChunkName: "usersAPI" */ "./common/usersAPI");
const btn = document.getElementById("btn");
btn.addEventListener("click", () => {
getUserModule().then(({ getUsers }) => {
getUsers().then(json => console.log(json));
});
});
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
准备工作
//借助插件
npm install babel-plugin-import --save-dev
// .babelrc
{
"plugins": [["import", {
"libraryName": "view-design",
"libraryDirectory": "src/components"
}]]
}
在main.js中引入
import "view-design/dist/styles/iview.css";
import { Button, Table } from "view-design";
const viewDesign = {
Button: Button,
Table: Table
};
Object.keys(viewDesign).forEach(element => {
Vue.component(element, viewDesign[element]);
});
先用google浏览器打开正常,以上操作猛如虎,IE浏览器打开250,好了不废话,下面是解决方案
解决方案
//vue.config.js中配置
chainWebpack: config => {
//解决iview 按需引入babel转换问题
config.module
.rule("view-design") // 我目前用的是新版本的iview ,旧版本的iview,用iview代替view-design
.test(/view-design.src.*?js$/)
.use("babel")
.loader("babel-loader")
.end();
}
问题原因
为什么会有如上问题呢? 这个就和babel转换问题有关了,按需引入时,那些组件里js文件未进行babel转换或转换不彻底就被引入了,ie11对es6+的语法支持是很差的,所以以上方法就是让引入文件前就对view-design的src下的所有js文件进行babel转换,举一反三,当按需引入第三方框架时出现这个问题,都可用这方法解决了,只要把规则和正则中view-design进行替换。
延伸扩展
//全局引入
import ViewUI from "view-design";
Vue.use(ViewUI);
import "view-design/dist/styles/iview.css";
tips:在全局引入时,一定要记住不要在.babelrc文件里配置按需导入,会导致冲突
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
最近在项目中遇到这样一个问题

当页面加载完毕后由于选项卡的另外两张属于display:none;状态 所以另外两张选项卡内echarts的宽高都会变成默认100*100
查阅了很多网上的案例,得出一下一些解决方案:
1:
原因很简单,在tab页中,图表的父容器div是隐藏的(display:none),图表在执行js初始化的时候找不到这个元素,所以自动将“100%”转成了“100”,最后计算出来的图表就成了100px
解决办法:
找一个在tab页的切换操作中不会隐藏的父容器,把它的宽度的具体值取出后在初始化图表之前直接赋给图表
1 $("#chartMain").css('width',$("#TabContent").width());//获取父容器的宽度具体数值直接赋值给图表以达到宽度100%的效果 2 var Chart = echarts.init(document.getElementById('chartMain')); 3 4 // 指定图表的配置项和数据 5 option = { ...配置项和数据 }; 6 7 // 使用刚指定的配置项和数据显示图表。 8 Chart.setOption(option);
2:mychart.resize() 重新渲染高度
3: 后来我想到了问题所在,既然高度是因为display:none;导致的 那大可不必设置这个属性,但是在页面渲染完毕后加上即可
所以取消了选项卡的display:none; 但在页面加载完毕后
window.οnlοad=function(){
根基id在添加css display:none;
}
即可解决,
分割线
---------------------------------------------------------------------
接下来解决一下ifram内外通讯 互相通讯赋值ifram src 和高度问题
统一资源定位符,缩写为URL,是对网络资源(网页、图像、文件)的引用。URL指定资源位置和检索资源的机制(http、ftp、mailto)。
举个例子,这里是这篇文章的 URL 地址:
https://dmitripavlutin.com/parse-url-javascript
很多时候你需要获取到一段 URL 的某个组成部分。它们可能是 hostname(例如 dmitripavlutin.com),或者 pathname(例如 /parse-url-javascript)。
一个方便的用于获取 URL 组成部分的办法是通过 URL() 构造函数。
在这篇文章中,我将给大家展示一段 URL 的结构,以及它的主要组成部分。
接着,我会告诉你如何使用 URL() 构造函数来轻松获取 URL 的组成部分,比如 hostname,pathname,query 或者 hash。
1. URL 结构
一图胜千言。不需要过多的文字描述,通过下面的图片你就可以理解一段 URL 的各个组成部分:
image
2. URL() 构造函数
URL() 构造函数允许我们用它来解析一段 URL:
const url = new URL(relativeOrAbsolute [, absoluteBase]);
参数 relativeOrAbsolute 既可以是绝对路径,也可以是相对路径。如果第一个参数是相对路径的话,那么第二个参数 absoluteBase 则必传,且必须为第一个参数的绝对路径。
举个例子,让我们用一个绝对路径的 URL 来初始化 URL() 函数:
const url = new URL('http://example.com/path/index.html');
url.href; // => 'http://example.com/path/index.html'
或者我们可以使用相对路径和绝对路径:
const url = new URL('/path/index.html', 'http://example.com');
url.href; // => 'http://example.com/path/index.html'
URL() 实例中的 href 属性返回了完整的 URL 字符串。
在新建了 URL() 的实例以后,你可以用它来访问前文图片中的任意 URL 组成部分。作为参考,下面是 URL() 实例的接口列表:
interface URL {
href: USVString;
protocol: USVString;
username: USVString;
password: USVString;
host: USVString;
hostname: USVString;
port: USVString;
pathname: USVString;
search: USVString;
hash: USVString;
readonly origin: USVString;
readonly searchParams: URLSearchParams;
toJSON(): USVString;
}
上述的 USVString 参数在 JavaScript 中会映射成字符串。
3. Query 字符串
url.search 可以获取到 URL 当中 ? 后面的 query 字符串:
const url = new URL(
'http://example.com/path/index.html?message=hello&who=world'
);
url.search; // => '?message=hello&who=world'
如果 query 参数不存在,url.search 默认会返回一个空字符串 '':
const url1 = new URL('http://example.com/path/index.html');
const url2 = new URL('http://example.com/path/index.html?');
url1.search; // => ''
url2.search; // => ''
3.1 解析 query 字符串
相比于获得原生的 query 字符串,更实用的场景是获取到具体的 query 参数。
获取具体 query 参数的一个简单的方法是利用 url.searchParams 属性。这个属性是 URLSearchParams 的实例。
URLSearchParams 对象提供了许多用于获取 query 参数的方法,如get(param),has(param)等。
下面来看个例子:
const url = new URL(
'http://example.com/path/index.html?message=hello&who=world'
);
url.searchParams.get('message'); // => 'hello'
url.searchParams.get('missing'); // => null
url.searchParams.get('message') 返回了 message 这个 query 参数的值——hello。
如果使用 url.searchParams.get('missing') 来获取一个不存在的参数,则得到一个 null。
4. hostname
url.hostname 属性返回一段 URL 的 hostname 部分:
const url = new URL('http://example.com/path/index.html');
url.hostname; // => 'example.com'
5. pathname
url. pathname 属性返回一段 URL 的 pathname 部分:
const url = new URL('http://example.com/path/index.html?param=value');
url.pathname; // => '/path/index.html'
如果这段 URL 不含 path,则该属性返回一个斜杠 /:
const url = new URL('http://example.com/');
url.pathname; // => '/'
6. hash
最后,我们可以通过 url.hash 属性来获取 URL 中的 hash 值:
const url = new URL('http://example.com/path/index.html#bottom');
url.hash; // => '#bottom'
当 URL 中的 hash 不存在时,url.hash 属性会返回一个空字符串 '':
const url = new URL('http://example.com/path/index.html');
url.hash; // => ''
7. URL 校验
当使用 new URL() 构造函数来新建实例的时候,作为一种副作用,它同时也会对 URL 进行校验。如果 URL 不合法,则会抛出一个 TypeError。
举个例子,http ://example.com 是一段非法 URL,因为它在 http 后面多写了一个空格。
让我们用这个非法 URL 来初始化 URL() 构造函数:
try {
const url = new URL('http ://example.com');
} catch (error) {
error; // => TypeError, "Failed to construct URL: Invalid URL"
}
因为 http ://example.com 是一段非法 URL,跟我们想的一样,new URL() 抛出了一个 TypeError。
8. 修改 URL
除了获取 URL 的组成部分以外,像 search,hostname,pathname 和 hash 这些属性都是可写的——这也意味着你可以修改 URL。
举个例子,让我们把一段 URL 从 red.com 修改成 blue.io:
const url = new URL('http://red.com/path/index.html');
url.href; // => 'http://red.com/path/index.html'
url.hostname = 'blue.io';
url.href; // => 'http://blue.io/path/index.html'
注意,在 URL() 实例中只有 origin 和 searchParams 属性是只读的,其他所有的属性都是可写的,并且会修改原来的 URL。
9. 总结
URL() 构造函数是 JavaScript 中的一个能够很方便地用于解析(或者校验)URL 的工具。
new URL(relativeOrAbsolute [, absoluteBase]) 中的第一个参数接收 URL 的绝对路径或者相对路径。当第一个参数是相对路径时,第二个参数必传且必须为第一个参数的基路径。
在新建 URL() 的实例以后,你就能很轻易地获得 URL 当中的大部分组成部分了,比如:
url.search 获取原生的 query 字符串
url.searchParams 通过 URLSearchParams 的实例去获取具体的 query 参数
url.hostname获取 hostname
url.pathname 获取 pathname
url.hash 获取 hash 值
那么你最爱用的解析 URL 的 JavaScript 工具又是什么呢?
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
为什么需要额外的类型检查?
TypeScript 只在编译期执行静态类型检查!实际运行的是从 TypeScript 编译的 JavaScript,这些生成的 JavaScript 对类型一无所知。编译期静态类型检查在代码库内部能发挥很大作用,但对不合规范的输入(比如,从 API 处接收的输入)无能为力。
运行时检查的严格性
至少需要和编译期检查一样严格,否则就失去了编译期检查提供的保证。
如有必要,可以比编译期检查更严格,例如,年龄需要大于等于 0。
运行时类型检查策略
定制代码手动检查
灵活
可能比较枯燥,容易出错
容易和实际代码脱节
使用校验库手动检查
比如使用 joi:
import Joi from "@hapi/joi"const schema = Joi.object({ firstName: Joi.string().required(), lastName: Joi.string().required(), age: Joi.number().integer().min(0).required()});
灵活
容易编写
容易和实际代码脱节
手动创建 JSON Schema
例如:
{ "$schema": "http://json-schema.org/draft-07/schema#", "required": [ "firstName", "lastName", "age" ], "properties": { "firstName": { "type": "string" }, "lastName": { "type": "string" }, "age": { "type": "integer", "minimum": 0 } }}
使用标准格式,有大量库可以校验。
JSON 很容易存储和复用。
可能会很冗长,手写 JSON Schema 可能会很枯燥。
需要确保 Schema 和代码同步更新。
自动创建 JSON Schema
基于 TypeScript 代码生成 JSON Schema
-- 比如 typescript-json-schema 这个工具就可以做到这一点(同时支持作为命令行工具使用和通过代码调用)。
-- 需要确保 Schema 和代码同步更新。
基于 JSON 输入示例生成
-- 没有使用已经在 TypeScript 代码中定义的类型信息。
-- 如果提供的 JSON 输入示例和实际输入不一致,可能导致错误。
-- 仍然需要确保 Schema 和代码同步更新。
转译
例如使用 ts-runtime。
这种方式会将代码转译成功能上等价但内置运行时类型检查的代码。
比如,下面的代码:
interface Person { firstName: string; lastName: string; age: number;}const test: Person = { firstName: "Foo", lastName: "Bar", age: 55}
会被转译为:
import t from "ts-runtime/lib";const Person = t.type( "Person", t.object( t.property("firstName", t.string()), t.property("lastName", t.string()), t.property("age", t.number()) ));const test = t.ref(Person).assert({ firstName: "Foo", lastName: "Bar", age: 55});
这一方式的缺陷是无法控制在何处进行运行时检查(我们只需在输入输出的边界处进行运行时类型检查)。
顺便提一下,这是一个实验性的库,不建议在生产环境使用。
运行时类型派生静态类型
比如使用 io-ts 这个库。
这一方式下,我们定义运行时类型,TypeScript 会根据我们定义的运行时类型推断出静态类型。
运行时类型示例:
import t from "io-ts";const PersonType = t.type({ firstName: t.string, lastName: t.string, age: t.refinement(t.number, n => n >= 0, 'Positive')})
从中提取相应的静态类型:
interface Person extends t.TypeOf<typeof PersonType> {}
以上类型等价于:
interface Person { firstName: string; lastName: string; age: number;}
类型总是同步的。
io-ts 很强大,比如支持递归类型。
需要将类型定义为 io-ts 运行时类型,这在定义类时不适用:
-- 有一种变通的办法是使用 io-ts 定义一个接口,然后让类实现这个接口。然而,这意味着每次给类增加属性的时候都要更新 io-ts 类型。
不容易复用接口(比如前后端之间使用同一接口),因为这些接口是 io-ts 类型而不是普通的 TypeScript 类型。
基于装饰器的类校验
比如使用 class-validator 这个库。
基于类属性的装饰器。
和 Java 的 JSR-380 Bean Validation 2.0 (比如 Hibernate Validator 就实现了这一标准)很像。
-- 此类 Java EE 风格的库还有 typeorm (ORM 库,类似 Java 的 JPA)和 routing-controllers (用于定义 API,类似 Java 的 JAX-RS)。
代码示例:
import { plainToClass } from "class-transformer";import { validate, IsString, IsInt, Min } from "class-validator";class Person { @IsString() firstName: string; @IsString() lastName: string; @IsInt() @Min(0) age: number;}const input: any = { firstName: "Foo", age: -1};const inputAsClassInstance = plainToClass( Person, input as Person);validate(inputAsClassInstance).then(errors => { // 错误处理代码});
类型总是同步的。
需要对类进行检查时很有用。
可以用来检查接口(定义一个实现接口的类)。
注意:class-validator 用于具体的类实例。在上面的代码中,我们使用它的姊妹库 class-transformer 将普通输入转换为 Person 实例。转换过程本身不进行任何类型检查。
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
如今,Page Speed(页面速度)的意义非凡。
自从Google改变Googlebot's的算法以高度支持快速,适合移动设备的网站以来,拥有快速网站变得越来越重要。如果这还不够好,用户通常会花更少的时间,转化率也会更低,你的网站体验越慢,用户的转化率就越低。
什么是Page Speed
Page Speed是将内容完全加载到网页上所花费的时间。
对于任何给定的用户来说,页面缓慢的原因可能有很多,你的用户可能正在火车上,通过信号弱的隧道,或者他们的互联网速度很慢。
通过遵循最佳实践,我们至少可以通过确保我们已经做了最好的工作来缓解问题。
现在你知道它是什么了,下面我就来教你如何提高页面速度。
注意:这些是按难度顺序列出的。在某个时候,你将需要开发人员来帮助优化你的网站。
1.使用CDN
CDN是内容传输网络的缩写。使用CDN可以让你有效地访问全球数百台小服务器,这些服务器为你提供网站的副本,大大减少了你的网站获取时间。如果你没有使用CDN,你的网站的每一个请求(包括图片、CSS和JavaScript)都会被缓慢地传送到你的服务器上。
根据HTTPArchive中的4.68亿个请求,48%的请求不是来自CDN。那是超过2.24亿的请求,如果他们花几分钟的时间给自己的网站添加一个CDN,速度可能会超过50%。
一定要检查你的CDN配置是否正确——在你的CDN中缓存丢失意味着CDN必须向你的源服务器请求资源,这就违背了使用CDN的初衷!所以,你的CDN必须要有一个正确的配置。
2.启用GZIP压缩
在一些CDN上,GZIP压缩只是一个标有 "启用压缩 "的复选框。这大概会减少一半的文件大小,你的用户需要下载文件才能使用你的网站,你的用户会因此而喜欢你。
3.使用较小的图像
这意味着既要降低分辨率(例如,摄像头的输出从4000x3000像素减少到网络的1000x750),又要通过压缩文件来减小尺寸。
如果你的网站使用WordPress,则有一些插件会在你上传图片时自动为你执行此操作。
在撰写博客文章时,我个人使用TinyJPG压缩图像。
https://tinyjpg.com/
4.减少页面发出的请求数
目标是减少加载页面顶部部分所需的请求数量。
这里有两种思维方式,你可以:
通过删除花哨的动画或不能改善网站体验的图像,减少整个页面上的请求数量。
或者,你可以通过使用延迟加载来推迟优先级不高的加载内容。
5.尽可能避免重定向
重定向会大大降低网站速度。使用响应式CSS并从一个域为你的网站提供服务,而不是为移动用户提供特殊的子域。
有些重定向是不可避免的,比如 www-> 根域 或 根域 ->www,但你的大部分流量不应该经历重定向来查看你的网站。
6.减少到第一个字节的时间
到第一个字节的时间是指你的浏览器在发出资源请求后,从服务器接收到第一个字节的数据所花费的时间。
有两个部分:
在服务器上花费的时间
发送数据所花费的时间
你可以通过优化你的服务器端渲染、数据库查询、API调用、负载平衡、你的应用程序的实际代码以及服务器的负载本身(特别是如果你使用的是廉价的虚拟主机——这将影响你的网站的性能),来改善你在服务器上花费的时间。
你可以使用CDN大大减少发送数据所花费的时间。
7.减少并删除阻止渲染的JavaScript
外部脚本(特别是那些用于营销的外部脚本)往往会写得很差,会阻止你的页面加载,直到它运行完毕。
你可以通过将外部脚本标记为异步来减少这种影响:
<script async src="https://example.com/external.js"></script>
你还可以延迟加载市场营销脚本,直到用户开始滚动为止:
window.addEventListener(
'scroll',
() =>
setTimeout(() => {
// 在此插入营销片段
}, 1000),
{ once: true }
);
8.缩小CSS和JS
Minifying是指使用工具来删除空格、换行符和缩短变量名。通常情况下,这将作为构建过程的一部分自动完成。
要缩小JavaScript,请查看UglifyJS。
http://lisperator.net/uglifyjs/
要缩小CSS,请查看cssnano。
9.删除未使用的CSS
自Chrome 59(2017年4月发布)以来,在Chrome DevTools中可以看到未使用的JS和CSS。
要看这个,打开DevTools,显示控制台抽屉(就是点击Esc时出现的那个烦人的东西),点击左下角的三个小点,打开 "Coverage",就可以看到。
点击带有重新加载图标的按钮将刷新页面,并审核CSS和JS的使用情况。
在Google Chrome浏览器中审核初始页面时,外观如下所示:
10.定期跟踪网站速度
在你的网站速度变慢的瞬间,修复网站速度问题就会容易得多。除此之外,如果你把检查网站速度作为一种习惯,那么修复网站速度慢的问题就会变成一件小得多的事情。
有免费的工具可以监视你网站的速度,其中的两个是WebPageTest和Google Lighthouse。这些工具的缺点是你需要记住在进行更改之前和之后都必须运行它们。
PerfBeacon是一项服务(由本文的作者创建),该服务定期运行Google Lighthouse,并让你随时跟踪网站的速度。
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
了解如何使用JavaScript中的Cache API缓存资源。
Cache API允许服务工作者对要缓存的资源(HTML页面、CSS、JavaScript文件、图片、JSON等)进行控制。通过Cache API,服务工作者可以缓存资源以供脱机使用,并在以后检索它们。
检测Cache支持
检查 caches 对象在 window 中是否可用。
let isCacheSupported = 'caches' in window;
caches 是 CacheStorage 的一个实例。
创建/初始化Cache
我们可以使用 open 方法创建一个具有 name 的缓存,这将返回 promise。如果缓存已经存在,则不会创建新的缓存。
caches.open('cacheName').then( cache => {
});
你不能访问为其他源(域)设置的缓存。
你正在创建的缓存将为你的域创建。
你可以为同一个域添加多个缓存,可以通过 caches.keys() 访问。
将项目添加到缓存
可以使用三种方法 add,addAll,set 来缓存资源。 add() 和 addAll() 方法自动获取资源并对其进行缓存,而在 set 方法中,我们将获取数据并设置缓存。
add
let cacheName = 'userSettings';
let url = '/api/get/usersettings';
caches.open(cacheName).then( cache => {
cache.add(url).then( () => {
console.log("Data cached ")
});
});
在上面的代码中,内部对 /api/get/usersettings url的请求已发送到服务器,一旦接收到数据,响应将被缓存。
addAll
addAll 接受URL数组,并在缓存所有资源时返回Promise。
let urls = ['/get/userSettings?userId=1', '/get/userDetails'];
caches.open(cacheName).then( cache => {
cache.addAll(urls).then( () => {
console.log("Data cached ")
});
});
Cache.add/Cache.addAll 不缓存 Response.status 值不在200范围内的响应,Cache.put 可以让你存储任何请求/响应对。
put
put 为当前的 Cache 对象添加一个key/value对,在 put 中,我们需要手动获取请求并设置值。
注意:put() 将覆盖先前存储在高速缓存中与请求匹配的任何键/值对。
let cacheName = 'userSettings';
let url = '/api/get/userSettings';
fetch(url).then(res => {
return caches.open(cacheName).then(cache => {
return cache.put(url, res);
})
})
从缓存中检索
使用 cache.match() 可以得到存储到URL的 Response。
const cacheName = 'userSettings'
const url = '/api/get/userSettings'
caches.open(cacheName).then(cache => {
cache.match(url).then(settings => {
console.log(settings);
}
});
settings 是一个响应对象,它看起来像
Response {
body: (...),
bodyUsed: false,
headers: Headers,
ok: true,
status: 200,
statusText: "OK",
type: "basic",
url: "https://test.com/api/get/userSettings"
}
检索缓存中的所有项目
cache 对象包含 keys 方法,这些方法将拥有当前缓存对象的所有url。
caches.open(cacheName).then( (cache) => {
cache.keys().then((arrayOfRequest) => {
console.log(arrayOfRequest); // [Request, Request]
});
});
arrayOfRequest是一个Request对象数组,其中包含有关请求的所有详细信息。
检索所有缓存
caches.keys().then(keys => {
// keys是一个数组,其中包含键的列表
})
从缓存中删除项目
可以对 cache 对象使用 delete 方法来删除特定的缓存请求。
let cacheName = userSettings;
let urlToDelete = '/api/get/userSettings';
caches.open(cacheName).then(cache => {
cache.delete(urlToDelete)
})
完全删除缓存
caches.delete(cacheName).then(() => {
console.log('Cache successfully deleted!');
})
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
作为一个曾经的Java coder, 当我第一次看到js里面的装饰器(Decorator)的时候,就马上想到了Java中的注解,当然在实际原理和功能上面,Java的注解和js的装饰器还是有很大差别的。本文题目是Vue中使用装饰器,我是认真的,但本文将从装饰器的概念开发聊起,一起来看看吧。
通过本文内容,你将学到以下内容:
了解什么是装饰器
在方法使用装饰器
在class中使用装饰器
在Vue中使用装饰器
本文首发于公众号【前端有的玩】,不想当咸鱼,想要换工作,关注公众号,带你每日一起刷大厂面试题,关注 === 大厂offer。
什么是装饰器
装饰器是ES2016提出来的一个提案,当前处于Stage 2阶段,关于装饰器的体验,可以点击 https://github.com/tc39/proposal-decorators查看详情。装饰器是一种与类相关的语法糖,用来包装或者修改类或者类的方法的行为,其实装饰器就是设计模式中装饰者模式的一种实现方式。不过前面说的这些概念太干了,我们用人话来翻译一下,举一个例子。
在日常开发写bug过程中,我们经常会用到防抖和节流,比如像下面这样
class MyClass {
follow = debounce(function() {
console.log('我是子君,关注我哦')
}, 100)
}
const myClass = new MyClass()
// 多次调用只会输出一次
myClass.follow()
myClass.follow()
上面是一个防抖的例子,我们通过debounce函数将另一个函数包起来,实现了防抖的功能,这时候再有另一个需求,比如希望在调用follow函数前后各打印一段日志,这时候我们还可以再开发一个log函数,然后继续将follow包装起来
/**
* 最外层是防抖,否则log会被调用多次
*/
class MyClass {
follow = debounce(
log(function() {
console.log('我是子君,关注我哦')
}),
100
)
}
上面代码中的debounce和log两个函数,本质上是两个包装函数,通过这两个函数对原函数的包装,使原函数的行为发生了变化,而js中的装饰器的原理就是这样的,我们使用装饰器对上面的代码进行改造
class MyClass {
@debounce(100)
@log
follow() {
console.log('我是子君,关注我哦')
}
}
装饰器的形式就是 @ + 函数名,如果有参数的话,后面的括号里面可以传参
在方法上使用装饰器
装饰器可以应用到class上或者class里面的属性上面,但一般情况下,应用到class属性上面的场景会比较多一些,比如像上面我们说的log,debounce等等,都一般会应用到类属性上面,接下来我们一起来具体看一下如何实现一个装饰器,并应用到类上面。在实现装饰器之前,我们需要先了解一下属性描述符
了解一下属性描述符
在我们定义一个对象里面的属性的时候,其实这个属性上面是有许多属性描述符的,这些描述符标明了这个属性能不能修改,能不能枚举,能不能删除等等,同时ECMAScript将这些属性描述符分为两类,分别是数据属性和访问器属性,并且数据属性与访问器属性是不能共存的。
数据属性
数据属性包含一个数据值的位置,在这个位置可以读取和写入值。数据属性包含了四个描述符,分别是
configurable
表示能不能通过delete删除属性,能否修改属性的其他描述符特性,或者能否将数据属性修改为访问器属性。当我们通过let obj = {name: ''}声明一个对象的时候,这个对象里面所有的属性的configurable描述符的值都是true
enumerable
表示能不能通过for in或者Object.keys等方式获取到属性,我们一般声明的对象里面这个描述符的值是true,但是对于class类里面的属性来说,这个值是false
writable
表示能否修改属性的数据值,通过将这个修改为false,可以实现属性只读的效果。
value
表示当前属性的数据值,读取属性值的时候,从这里读取;写入属性值的时候,会写到这个位置。
访问器属性
访问器属性不包含数据值,他们包含了getter与setter两个函数,同时configurable与enumerable是数据属性与访问器属性共有的两个描述符。
getter
在读取属性的时候调用这个函数,默认这个函数为undefined
setter
在写入属性值的时候调用这个函数,默认这个函数为undefined
了解了这六个描述符之后,你可能会有几个疑问: 我如何去定义修改这些属性描述符?这些属性描述符与今天的文章主题有什么关系?接下来是揭晓答案的时候了。
使用Object.defineProperty
了解过vue2.0双向绑定原理的同学一定知道,Vue的双向绑定就是通过使用Object.defineProperty去定义数据属性的getter与setter方法来实现的,比如下面有一个对象
let obj = {
name: '子君',
officialAccounts: '前端有的玩'
}
我希望这个对象里面的用户名是不能被修改的,用Object.defineProperty该如何定义呢?
Object.defineProperty(obj,'name', {
// 设置writable 是 false, 这个属性将不能被修改
writable: false
})
// 修改obj.name
obj.name = "君子"
// 打印依然是子君
console.log(obj.name)
通过Object.defineProperty可以去定义或者修改对象属性的属性描述符,但是因为数据属性与访问器属性是互斥的,所以一次只能修改其中的一类,这一点需要注意。
定义一个防抖装饰器
装饰器本质上依然是一个函数,不过这个函数的参数是固定的,如下是防抖装饰器的代码
/**
*@param wait 延迟时长
*/
function debounce(wait) {
return function(target, name, descriptor) {
descriptor.value = debounce(descriptor.value, wait)
}
}
// 使用方式
class MyClass {
@debounce(100)
follow() {
console.log('我是子君,我的公众号是 【前端有的玩】,关注有惊喜哦')
}
}
我们逐行去分析一下代码
首先我们定义了一个 debounce函数,同时有一个参数wait,这个函数对应的就是在下面调用装饰器时使用的@debounce(100)
debounce函数返回了一个新的函数,这个函数即装饰器的核心,这个函数有三个参数,下面逐一分析
target: 这个类属性函数是在谁上面挂载的,如上例对应的是MyClass类
name: 这个类属性函数的名称,对应上面的follow
descriptor: 这个就是我们前面说的属性描述符,通过直接descriptor上面的属性,即可实现属性只读,数据重写等功能
然后第三行 descriptor.value = debounce(descriptor.value, wait), 前面我们已经了解到,属性描述符上面的value对应的是这个属性的值,所以我们通过重写这个属性,将其用debounce函数包装起来,这样在函数调用follow时实际调用的是包装后的函数
通过上面的三步,我们就实现了类属性上面可使用的装饰器,同时将其应用到了类属性上面
在class上使用装饰器
装饰器不仅可以应用到类属性上面,还可以直接应用到类上面,比如我希望可以实现一个类似Vue混入那样的功能,给一个类混入一些方法属性,应该如何去做呢?
// 这个是要混入的对象
const methods = {
logger() {
console.log('记录日志')
}
}
// 这个是一个登陆登出类
class Login{
login() {}
logout() {}
}
如何将上面的methods混入到Login中,首先我们先实现一个类装饰器
function mixins(obj) {
return function (target) {
Object.assign(target.prototype, obj)
}
}
// 然后通过装饰器混入
@mixins(methods)
class Login{
login() {}
logout() {}
}
这样就实现了类装饰器。对于类装饰器,只有一个参数,即target,对应的就是这个类本身。
了解完装饰器,我们接下来看一下如何在Vue中使用装饰器。
在Vue中使用装饰器
使用ts开发Vue的同学一定对vue-property-decorator不会感到陌生,这个插件提供了许多装饰器,方便大家开发的时候使用,当然本文的中点不是这个插件。其实如果我们的项目没有使用ts,也是可以使用装饰器的,怎么用呢?
配置基础环境
除了一些老的项目,我们现在一般新建Vue项目的时候,都会选择使用脚手架vue-cli3/4来新建,这时候新建的项目已经默认支持了装饰器,不需要再配置太多额外的东西,如果你的项目使用了eslint,那么需要给eslint配置以下内容。
parserOptions: {
ecmaFeatures:{
// 支持装饰器
legacyDecorators: true
}
}
使用装饰器
虽然Vue的组件,我们一般书写的时候export出去的是一个对象,但是这个并不影响我们直接在组件中使用装饰器,比如就拿上例中的log举例。
function log() {
/**
* @param target 对应 methods 这个对象
* @param name 对应属性方法的名称
* @param descriptor 对应属性方法的修饰符
*/
return function(target, name, descriptor) {
console.log(target, name, descriptor)
const fn = descriptor.value
descriptor.value = function(...rest) {
console.log(`这是调用方法【${name}】前打印的日志`)
fn.call(this, ...rest)
console.log(`这是调用方法【${name}】后打印的日志`)
}
}
}
export default {
created() {
this.getData()
},
methods: {
@log()
getData() {
console.log('获取数据')
}
}
}
看了上面的代码,是不是发现在Vue中使用装饰器还是很简单的,和在class的属性上面使用的方式一模一样,但有一点需要注意,在methods里面的方法上面使用装饰器,这时候装饰器的target对应的是methods。
除了在methods上面可以使用装饰器之外,你也可以在生命周期钩子函数上面使用装饰器,这时候target对应的是整个组件对象。
一些常用的装饰器
下面小编罗列了几个小编在项目中常用的几个装饰器,方便大家使用
1. 函数节流与防抖
函数节流与防抖应用场景是比较广的,一般使用时候会通过throttle或debounce方法对要调用的函数进行包装,现在就可以使用上文说的内容将这两个函数封装成装饰器, 防抖节流使用的是lodash提供的方法,大家也可以自行实现节流防抖函数哦
import { throttle, debounce } from 'lodash'
/**
* 函数节流装饰器
* @param {number} wait 节流的毫秒
* @param {Object} options 节流选项对象
* [options.leading=true] (boolean): 指定调用在节流开始前。
* [options.trailing=true] (boolean): 指定调用在节流结束后。
*/
export const throttle = function(wait, options = {}) {
return function(target, name, descriptor) {
descriptor.value = throttle(descriptor.value, wait, options)
}
}
/**
* 函数防抖装饰器
* @param {number} wait 需要延迟的毫秒数。
* @param {Object} options 选项对象
* [options.leading=false] (boolean): 指定在延迟开始前调用。
* [options.maxWait] (number): 设置 func 允许被延迟的最大值。
* [options.trailing=true] (boolean): 指定在延迟结束后调用。
*/
export const debounce = function(wait, options = {}) {
return function(target, name, descriptor) {
descriptor.value = debounce(descriptor.value, wait, options)
}
}
封装完之后,在组件中使用
import {debounce} from '@/decorator'
export default {
methods:{
@debounce(100)
resize(){}
}
}
2. loading
在加载数据的时候,为了个用户一个友好的提示,同时防止用户继续操作,一般会在请求前显示一个loading,然后在请求结束之后关掉loading,一般写法如下
export default {
methods:{
async getData() {
const loading = Toast.loading()
try{
const data = await loadData()
// 其他操作
}catch(error){
// 异常处理
Toast.fail('加载失败');
}finally{
loading.clear()
}
}
}
}
我们可以把上面的loading的逻辑使用装饰器重新封装,如下代码
import { Toast } from 'vant'
/**
* loading 装饰器
* @param {*} message 提示信息
* @param {function} errorFn 异常处理逻辑
*/
export const loading = function(message = '加载中...', errorFn = function() {}) {
return function(target, name, descriptor) {
const fn = descriptor.value
descriptor.value = async function(...rest) {
const loading = Toast.loading({
message: message,
forbidClick: true
})
try {
return await fn.call(this, ...rest)
} catch (error) {
// 在调用失败,且用户自定义失败的回调函数时,则执行
errorFn && errorFn.call(this, error, ...rest)
console.error(error)
} finally {
loading.clear()
}
}
}
}
然后改造上面的组件代码
export default {
methods:{
@loading('加载中')
async getData() {
try{
const data = await loadData()
// 其他操作
}catch(error){
// 异常处理
Toast.fail('加载失败');
}
}
}
}
3. 确认框
当你点击删除按钮的时候,一般都需要弹出一个提示框让用户确认是否删除,这时候常规写法可能是这样的
import { Dialog } from 'vant'
export default {
methods: {
deleteData() {
Dialog.confirm({
title: '提示',
message: '确定要删除数据,此操作不可回退。'
}).then(() => {
console.log('在这里做删除操作')
})
}
}
}
我们可以把上面确认的过程提出来做成装饰器,如下代码
import { Dialog } from 'vant'
/**
* 确认提示框装饰器
* @param {*} message 提示信息
* @param {*} title 标题
* @param {*} cancelFn 取消回调函数
*/
export function confirm(
message = '确定要删除数据,此操作不可回退。',
title = '提示',
cancelFn = function() {}
) {
return function(target, name, descriptor) {
const originFn = descriptor.value
descriptor.value = async function(...rest) {
try {
await Dialog.confirm({
message,
title: title
})
originFn.apply(this, rest)
} catch (error) {
cancelFn && cancelFn(error)
}
}
}
}
然后再使用确认框的时候,就可以这样使用了
export default {
methods: {
// 可以不传参,使用默认参数
@confirm()
deleteData() {
console.log('在这里做删除操作')
}
}
}
是不是瞬间简单多了,当然还可以继续封装很多很多的装饰器,因为文章内容有限,暂时提供这三个。
装饰器组合使用
在上面我们将类属性上面使用装饰器的时候,说道装饰器可以组合使用,在Vue组件上面使用也是一样的,比如我们希望在确认删除之后,调用接口时候出现loading,就可以这样写(一定要注意顺序)
export default {
methods: {
@confirm()
@loading()
async deleteData() {
await delete()
}
}
}
本节定义的装饰器,均已应用到这个项目中 https://github.com/snowzijun/vue-vant-base, 这是一个基于Vant开发的开箱即用移动端框架,你只需要fork下来,无需做任何配置就可以直接进行业务开发,欢迎使用,喜欢麻烦给一个star。
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
蓝蓝设计的小编 http://www.lanlanwork.com