区块链
区块链(Blockchain)是指通过去中心化和去信任的方式集体维护一个可靠数据库的技术方案。该技术方案让参与系统中的任意多个节点,把一段时间系统内全部事务通过密码学算法计算并记录到一个数据块(block),生成该数据块的hash用于链接下个数据块,系统所有参与节点来共同检验记录是否为真,并且每个区块的内容都由后续子链上的区块来保证其内容不可被篡改。 各个参与节点可以在新区块产生确认及奖励分配上达成共识,从而逐渐形成的一个庞大、去中心化的公开账本。
01 对比特币的认识
2008年,中本聪(Satoshi Nakamoto)发表了一篇题为“比特币:一种点对点的电子现金系统”的论文描述了比特币的模式。
新区块的创造过程是一个区块创造权的竞争的过程,即通过工作量证明来选定新区块的创造者。在任何一个特定的时间点上,整个区块链系统范围内的,所有竞争者在同时开始,共同针对同一特定新候选区块进行哈希运算比赛。获胜的条件是最先算出符合该特定新候选区块要求的哈希值。获胜的(只能有一个获胜者)奖励是伴随该新区块一起发行的全部新比特币。当一个新区块被创造出来了,所有的竞争者马上重新开始进行对下一个区块创造权的竞争。
新区块的创造速度大概是10分钟一块。
比特币的存储依靠的就是分布式账本技术。比特币就是一串数据代码。所有的比特币就是记录于区块链中各自对应的区块内,然后分布式存放于比特币系统的各个节点上。比特币区块链就像是一个由比特币系统所有的节点共享的统一电子账本。
比特币的使用就是比特币的交易,也就是比特币所有权的转换。比特币的使用主要是通过加密技术来实现的
02 对以太坊的认识
以太坊是一个具有智能合约功能的开放区块链平台,使开发人员能够建立和发布各种分布式应用。通过在以太坊上编程建立各种分布式应用可以解决诸如:投票、域名、金融交易、众筹、公司管理、合约、知识产权、硬件集成的智能资产等等各方面问题。
以太坊,与比特币区块链技术一样,使用激励驱动的安全模式。共识达成基于选择具有最高总难度的区块。矿工创建区块,其他人检测有效性。
以太币是于2015年7月30日开始发行的。类似于比特币,以太币的发行方式也是采用工作量证明机制(POW)。通过工作量证明机制,以太坊每年发行15,626,576枚以太币。以太坊计划于2017年末将以太币的发行方式改为权益证明机制(POS)。届时,每年的新发行的以太币数量为1000万枚。以太币的总发行量是没有上限的。
以太坊是通过在比特币区块链系统基础上进行修改和创新而产生的。以太坊本质上就是:区块链+智能合约
(1) 什么是以太坊虚拟机
同比特币区块链系统不同,以太坊设计了以太坊虚拟机(EVM)专门用来运行智能合约。太坊虚拟机是一个同网络,文件系统或者其他操作过程隔绝开来的封装起来的计算机代码运行环境.
(2)以太坊的账户
以太坊的基础单元是账户. 这些账户可以通过消息传递来发生互动变化。每个账户都有一个与之关联的状态和一个20字节的地址。所有价值和信息的转移都体现为账户状况的变化.以太坊区块链通过控制所有账户的变化实现其各种功能.
以太坊有两类账户: 外部账户和合约账户,他们被存放于同一地址空间上.外部账户是由人类用户通过对应的公私钥来掌控。而合约账户则是由被存储在其内部的代码掌控。智能合约指的是合约账户中的那些对被发送来的交易进行自动处理的程序代码。用户可以通过在区块链中存储程序代码来创建新的智能合约。
以太坊账户状态的变化就是指以太坊账户组成成分发生的变化。以太坊账户含有四个组成部分:
(1) 序号(nonce):如果账户是一个外部拥有账户,nonce代表从此账户地址发送的交易序号。如果账户是一个合约账户,nonce代表此账户创建的合约序号。
(2) 余额(balance): 此地址拥有Wei的数量。
(3) Merkle 树根的哈希值: Merkle树会将此账户存储内容的哈希值进行编码,默认值是空值。
(4) 代码哈希值:此账户太坊虚拟机内的代码的哈希值。对于合约账户,就是被哈希的代码并作为代码哈希值保存起来。对于外部账户,代码哈希值是一个空字符串的哈希值。
(3)以太坊的交易和交易费用
太坊区块链系统只有两种类型的交易:合约创建和消息通信。
以太坊所有的交易都是在外部账户触动下发生的.合约账户不会自发地产生任何行动. 只有当外部账户发出交易时,合约账户才会执行相应的操作。以太坊通过规定节点必须与运算结果保持一致,从而保证智能合约严格确定执行。
在以太坊中一个重要的概念就是费用(fees). 发生在以太坊区块链系统内的交易而产生的每一次计算都会要求相应的费用。这个费用是以”gas”的来支付。gas就是用来衡量在一个具体计算中要求的费用单位。gas 价格(gas price)就是你愿意在每个gas花费ETH的数量,以“gwei”进行衡量。“Wei”是ETH的最小单位,1ETH表示10^18Wei. 1gwei是1,000,000,000 Wei。
发生交易时,交易发送者先设置gas limit和gas price。gas limit和gas price就代表着发送者愿意为执行交易支付的Wei的最大值。以太坊用户必须向以太坊区块链系统支付少量交易费用。交易的发送者必须在激活的合约账户的每一步为所有的运算和数据存储付费。如果在他们的账户余额中有足够的Ether来支付这个最大值费用,那么就没问题。在交易结束时任何未使用的gas都会被返回给发送者,以原始费率兑换。费用通过以太坊Gas结算,以太币的形式支付的。这样可以帮助太坊区块链系统避免被滥用或被恶意攻击.
交易费用由节点收集,节点在以太坊网络中完成收集、传播、确认和执行交易的工作。矿工们将交易活动分组:交易记录(以太坊区块链中账户状态的更新)被分组存放在区块中;节点通过互相竞争决定添加权;获得添加权的节点将新的区块添加到区块链的上。获得添加权的节点会得到以太币奖励,通过这些奖励激励节点为以太坊区块链系统贡献硬件和电力。
(4)以太坊的状态变化机制
第一步,检查交易的格式是否正确(即有正确数值)、签名是否有效和随机数是否与发送者账户的随机数匹配。如否,返回错误。
第二步,计算交易费用,并从签名中确定发送者的地址。从发送者的账户中减去交易费用和增加发送者的随机数。如果账户余额不足,返回错误。
第三步,设定初值GAS = STARTGAS,并根据交易中的字节数减去一定量的Gas值。
第四步,从发送者的账户转移价值到接收者账户。如果接收账户还不存在,创建此账户。如果接收账户是一个合约,运行合约的代码,直到代码运行结束或者燃料用完。
第五步,如果因为发送者账户没有足够的钱或者代码执行耗尽燃料导致价值转移失败,恢复原来的状态,但是还需要支付交易费用,交易费用加至矿工账户。
第六步,否则,将所有剩余的燃料归还给发送者,消耗掉的燃料作为交易费用发送给矿工。
03 **对Hyperledger的认识
04 了解其他那些区块链项目 Corda EOS
05 公链、联盟链、私链的区别
中本聪巧妙地将以下几个成熟的技术和理论组合的一起,并以此为基础构建区块链技术:
基于去中心化的分布式算法而建立起点对点对等(P2P)网络。
基于非对称加密算法。
基于分布式一致性算法,解决了分布式场景下的拜占庭将军问题。
基于博弈论而精心设计的奖励机制,实现了纳什均衡,确保整个系统的安全和稳定运行。
如果同时具有上述四点要素,可以认为这是一种公共区块链技术,简称公有链。如果只具有前三点要素,将其称为私有区块链技术,简称私有链。而联盟链则介于两者之间,可视为联盟成员内的一种私有链。这里主要介绍公有链和私有链。
公链是指全世界任何人都可读取的、任何人都能发送事务且能获得有效确认的、任何人都能参与共识过程的区块链。共识过程决定哪个区块可被添加到区块链中和明确当前状态。作为中心化或者准中心化信任的替代物,公有链的安全由加密数字经济维护。加密数字经济采取工作量证明机制或权益证明机制等方式,将经济奖励和加密数字验证结合了起来,并遵循着一般原则:每个人从中可获得的经济奖励,与对共识过程作出的贡献成正比。这些区块链通常被认为是完全去中心化的。
私有链是指其写入权限仅在一个组织手里的区块链。读取权限或者对外开放,或者被限制。相关的应用囊括数据库管理、审计、甚至一个公司,尽管在有些情况下希望它能有公共的可审计性,但在很多的情形下,公共的可读性并非是必须的。
私有链相比于公有链的优点:
事务的效率更高:比特币区块链目前每秒可完成7笔事务,而私有链目前最高可以到每秒10万笔,并且还有提高的空间。显然后者更适应现实世界金融事务的需求。
事务可以回滚:这点对于中心化机构也很重要,在某些情况下,某些事务会因为错误或法律的问题而被要求修改、撤销。
事务费用更低:目前公有链的事务费用是每笔0.10美元,而且随着时间流逝币值趋于增长,导致事务费用也在增长。而私有链的事务费用将会降低一到两个数量级。
仍然是基于分布式网络,保留了分布式记账系统的优点。
提供了更好的隐私保护:公有区块链因为其透明共享总账本的设计,本身不提供隐私保护功能。而私有链可以对读取权限进行限制,从而提供更好的隐私保护。
验证者是公开透明的,不存在一些矿工出于共谋原因而致的51%攻击风险。
节点可以很好地连接:节点互相可以很好地连接,故障可以迅速通过人工干预来修复,并允许使用共识算法减少区块时间,从而更快完成事务。
私有链的缺点:
违背了区块链去中心化的本质,重新引入了若干“信任节点”;
其参与者需要经过审核和验证,从而严格限制了其规模,其安全性容易受到威胁。因此,私有区块链更适合为传统机构所用。
公有链的优点:
保护用户:免受开发者的影响——在公共区块链中的用户更多、更广泛,程序开发者无权干涉
用户的使用方式。反过来说,区块链可以保护使用这些程序的用户。
网络规模效应——公共区块链是开放的,因此有可能被许多外界用户使用和产生一定的网络效应。而在公有链上运行的应用越多,节点越多,那么该区块链条也会越可信。
因此使用公有链,还是私有链,完全根据需求而定。
06 了解哪些共识算法
07 说说最熟悉的共识算法
08 看过哪些书
09 以太坊智能合约
10 拜占庭问题
在互联网大背景下,当需要与不熟悉的对方进行价值交换活动时,人们如何才能防止不会被其中的恶意破坏者欺骗、迷惑从而作出错误的决策。进一步将“拜占庭将军问题”延伸到技术领域中来,其内涵可概括为:在缺少可信任的中央节点和可信任的通道的情况下,分布在网络中的各个节点应如何达成共识
11 51%算力攻击
在比特币网络中,采用PoW共识机制来解决如何获得记账权的问题,采用“最长链共识”解决如何记账的问题。
所谓51%的攻击,就是利用比特币网络采用PoW竞争记账权和“最长链共识”的特点,使用算力优势生成一条更长的链“回滚”已经发生的“交易行为”。
51%是指算力占全网算力的51%,比特币网络需要通过哈希碰撞来匹配随机数从而获得记账权,算力衡量的是一台计算机每秒钟能进行哈希碰撞的次数。
算力越高,意味着每秒钟能进行越多次的哈希碰撞,即获得记账权的几率越高。
在理论上,如果掌握了50%以上的算力,就拥有了获得记账权的绝对优势,可以更快地生成区块,也拥有了篡改区块链数据的权利。
实际上,当恶意攻击者持有比特币全网占比比较高的算力时,即使尚未达到51%的比例,也可以制造相应的攻击,比较典型的就是双花问题。
12 Sybil攻击
在对等网络中,但节点通常具有多个身份标识,通过控制系统的大部分节点来消弱冗余备份的作用
13 Eclipse攻击
Eclipse攻击是一种网络级的攻击,攻击者模仿所有其他节点的入流量和出流量,达到将受害者与网络上的其他节点隔离的目的。这种攻击意味着通过让最新的区块信息不能到达节点来达到隔离节点的目的。事实上,比特币网络也易受到eclipse攻击。但在以太坊网络上,两个节点就足以发起eclipse攻击。
14 DDoS攻击
是指处于不同位置的多个攻击者同时向一个或数个目标发动攻击,或者一个攻击者控制了位于不同位置的多台机器并利用这些机器对受害者同时实施攻击。由于攻击的发出点是分布在不同地方的,这类攻击称为分布式拒绝服务攻击,其中的攻击者可以有多个。
15 Merkle Tree数据结构
A、Merkle树结构
由一个根节点(root)、一组中间节点和一组叶节点(leaf)组成。叶节点(leaf)包含存储数据或其哈希值,中间节点是它的两个孩子节点内容的哈希值,根节点也是由它的两个子节点内容的哈希值组成。所以Merkle树也称哈希树。
B、哈希树的特点
叶节点存储的是数据文件,而非叶节点存储的是其子节点的哈希值(Hash,通过SHA1、SHA256等哈希算法计算而来),这些非叶子节点的Hash被称作路径哈希值(可以据其确定某个叶节点到根节点的路径),
叶节点的Hash值是真实数据的Hash值。因为使用了树形结构, 其查询的时间复杂度为 O(logn),n是节点数量。
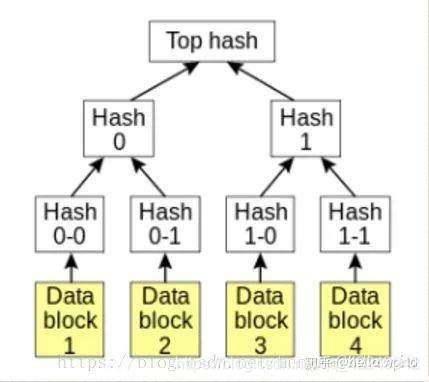
默克尔树的另一个特点是,底层数据的任何变动,都会传递到其父节点,一直到树根。
16 哈希算法
哈希算法(Hash)又称摘要算法(Digest),它的作用是:对任意一组输入数据进行计算,得到一个固定长度的输出摘要。
哈希算法最重要的特点就是:
相同的输入一定得到相同的输出;
不同的输入大概率得到不同的输出。
哈希算法的目的就是为了验证原始数据是否被篡改。
17 看过那些白皮书 bitcoin ethereum EOS
18 未来你看好那些区块链项目
19 区块链的应用场景
20 以太坊协议 ERC20 ERC721 ERC223 ERC875
21.什么是挖矿?
挖矿是在区块链网络达成共识的过程。挖矿有两个目的。首先,它在生成的块中创建新的代币。其次,它通过向网络提供工作证明,包括分布式计费中的交易;也就是说,证明所生成的块是有效的。
22.比特币实现中的交易和块是如何加密的?
比特币块不以任何方式加密:每个块都是公开的。阻止修改和保证数据完整性的是一个称为块哈希的值。块的内容是使用在比特币的一种特殊Hash函数来处理,它的实现和得到的值包含在区块链中。
23.什么是软分叉?
在分类帐中的块包括以建立最长链的方式,即具有最大累积难度的链。分叉是有两个候选块竞争形成最长的区块链,两个矿工发现工作问题的证明方法在很短的时间内没有同步对方的情况。造成网络分割,因为某些节点得到块从矿工#1和而另外一些得到矿工#2。 分叉通常在一个块中得到解决,因为这种情况再次发生的概率变得非常低,因为下一个块出现,所以很快有一个新的最长链,将被认为是主要的。
**24.**什么是双重支出?
这是与数字货币有关的主要问题之一。 事实上,这是一个数字通证被多次使用的条件,因为通证通常由易于克隆的数字文件组成。它只会导致通货膨胀,组织不得不承受巨大的损失。 区块链技术的主要目标之一是尽可能地消除这种方法。
------开发基础篇--------
01 go语言问题
02 solidity语言语法问题
03 c/c++语言语法问题
04 java语言语法问题
问:以太坊的有价通证叫什么?
答:以太(ETH:Ether)
问:Wei和以太有什么区别?
答:Wei是一个面额,像美分到美元或便士到磅。 1 ETH =10^18 Wei
问:以太坊的平均出块时间是多少?
答:大约14秒
问:以太坊的平均块大小是多少?
答:大约2KB,实际值取决于具体情况。
问:以太坊是否支持脚本? 如果是这样,支持什么类型的脚本?
答:是的。 它支持智能合约
问:你如何得到以太?
答:有几种方法:
1.成为一名矿工
2.用其他货币换取
3.使用以太Faucet,例如 https://faucet.metamask.io
4.接受别人的赠送
问:以太从哪里来的?
答:在2014年预售中首次创建了6000万个。另外,在挖出新块时也会生成以太。
问:什么是节点?
答:一个节点本质上是一台连接到网络的计算机,它负责处理交易。
问:你熟悉多少种以太坊网络?
答:有三种类型的网络 - 实时网络(主),测试网络(如Ropsten和Rinkeby)和私有网络。
问:与以太坊网络交互的方式有哪些?
答:可以使用电子钱包或DApp
问:你可以“隐藏”一个以太坊交易吗?
答:不可以。所有交易对每个人都是可见的。
问:交易记录在哪里?
答:在公共账本上。
问:这些网络的ID是什么?
答:Live(id = 1),Ropsten(id = 3),Rinkeby(id = 4),Private(由开发人员分配)
问:我可以在Rinkeby测试网络中挖一些以太,然后转移到Live网络吗?
答:不可以。不能在不同的以太坊网络之间传递以太。
问:为什么需要私有网络?
答:有很多原因,但主要是为了数据隐私、分布式数据库、权限控制和测试。
问:你如何轻松查看有关交易和区块的详细信息?
答:使用区块链浏览器,如etherscan.io或live.ether.camp
问:私有网络的交易和区块信息怎么查看呢?
答:可以使用开源浏览器客户端,例如https://github.com/etherparty/explorer
问:区块链的共识是什么?
答:遵循特定协议(如以太坊)验证交易(创建块)的过程。
问:区块链中两种常用的共识模型是什么?
答:工作量证明(POW)和权益证明(POS)。
问:简单地解释下工作量证明。
答:它实际上是矿工为了证明自己的工作量并验证交易而对一个计算密集型问题的求解。
问:以简单的方式解释权益证明。
答:区块的创建者是根据节点所持有的财富和股权随机选择的。 它不是计算密集型的。
问:以太坊使用什么共识模式?
答:截至2018年初,它使用工作量证明,但今后将切换到权益证明。
问:怎么挖以太币?
答:使用钱包或geth客户端。
问:用什么来对交易进行签名?
答:用户的私钥。
问:丢失私钥后还能恢复以太坊账户吗?
答:可以,可以使用助记词组。
问:有哪些方法可以连接到一个以太坊节点?
答:IPC-RPC、JSON-RPC和WS-RPC。
问:那么Geth是什么?
答:Geth是以太坊的客户端。
问:连接到geth客户端的默认方式是什么?
答:默认情况下启用IPC-RPC,其他RPC都被禁用。
问:你知道geth的哪些API?
答:Admin、eth、web3、miner、net、personal、shh、debug和txpool。
问:你可以使用哪些RPC通过网络连接到geth客户端?
答:可以使用JSON-RPC和WS-RPC通过网络连接到geth客户端。 IPC-RPC只能连接到同一台机器上的geth客户端。
问:如果启动geth时使用了-rpc选项,哪些RPC会被启用?
答:JSON-RPC。
问:哪些RPC API是默认启用的?
答:eth、web3和net。
问:如何为JSON RPC启用Admin API?
答:使用-rpcapi选项。
问:选项-datadir有什么作用?
答:它指定了区块链的存储位置。
问:什么是geth的“快速”同步,为什么它更快?
答:快速同步会将事务处理回执与区块一起下载并完整提取最新的状态数据库,而不是重新执行所有发生过的交易。
问:选项–testnet是做什么的?
答:它将客户端连接到Ropsten网络。
问:启动geth客户端会在屏幕上输出大量文字,应该如何减少输出信息?
答:可以将–verbosity设置为较低的数字(默认值为3)
问:如何使用IPC-RPC将一个geth客户端连接到另一个客户端?
答:首先启动一个geth客户端,复制它的管道位置,然后使用同一个datadir启动另一个geth客户端并使用–attach选项传入管道位置。
问:如何将自定义javascript文件加载到geth控制台中?
答:通使用–preload选项传入js文件的路径。
问:geth客户端的帐户存储在哪里?
答:在keystore目录中。
问:为了进行交易,需要对账户进行什么操作?
答:必须先解锁该账户 - 可以传入账户地址或账户序号来解锁。 也可以使用–password选项传入一个密码文件,其中包含每个账户的密码。
问:你提到了一些有关账户序号的内容。 什么因素决定账户的序号?
答:添加帐户的先后顺序。
问:是否可以使用geth进行挖矿?
答:可以,使用–mine选项开启。
问:什么是“etherbase”?
答:这是接收挖矿奖励的帐户,它是序号为0的帐户。
问:什么是智能合约?
答:这是用多种语言编写的计算机代码。 智能合约存在于以太坊网络上,它们根据预定规则执行动作,规则是由参与者在这些合约中商定的。
问:智能合约可以使用哪些语言编写?
答:Solidity,这是最常用的语言,也可以使用Serpent和LLL。
问:你能举出一个智能合约的用例吗?
答:卖方-买方应用场景:买方在智能合约中存入款项,卖方看到存款并发送货物,买方收到货物并放行付款。
问:什么是Metamask?
答:Metamask是一个可以帮助用户在浏览器中与以太坊网络进行交互的工具
问:Metamask使用哪个以太坊节点?
答:它使用infura.io
问:Metamask不支持什么?
答:挖矿和合约部署。
问:执行合约是否免费?
答:不,调用合约方法是一个交易,因此需要支付费用。
问:访问智能合约的状态是否免费?
答:是的,查询状态不是交易。
问:谁执行合同?
答:矿工。
问:为什么调用智能合约的方法需要付费?
答:有些方法不会修改合约的状态,也没有其他逻辑,只是返回一个值,这样的方法是可以免费调用的。 调用那些改变合约状态的方法则需要付费,因为它们需要gas来执行。
问:为什么需要gas?
答:由于矿工在他们的机器上执行合约代码,他们需要gas来覆盖执行合约代码的成本。
问:是不是gas的价格决定了交易什么时候被处理?
答:即是,也不是。 gas价格越高,交易成功的可能性就越大。 尽管如此,gas价格并不能保证更快的交易处理。
问:交易中的gas使用量取决于什么?
答:这取决于合约所用的存储量、指令(操作码)的类型和数量。 每个EVM操作码都对应一个固定的gas用量。
问:交易费是如何计算的?
答:gas用量*gas价格(由调用方指定gas价格)
问:如果智能合约的执行成本低于调用方指定的gas用量,用户是否得到退款?
答:是的
问:如果智能合约的执行成本高于指定的gas用量,会发生什么情况?
答:用户不会得到退款,并且一旦所有的gas用完,执行就会停止,合约也不会改变。
问:谁支付智能合约的调用费用?
答:调用合约的用户。
问:节点在什么上面运行智能合约代码?
答:EVM - 以太坊虚拟机。 EVM遵循EVM规范,该规范是以太坊协议的组成部分。 EVM只是节点上的一个进程。
问:为了运行智能合同,EVM需要什么?
答:它需要合约的字节码,是通过编译Solidity等更高级别的语言编写的合约来生成字节码。
问:粗略的说,EVM有哪些组成部分?
答:内存区域、堆栈和执行引擎。
问:什么是Remix?
答:开发,测试和部署合约的在线工具。 适合快速构建和测试轻量级合约,但不适合更复杂的合约。
问:在Remix中,可以连接哪些节点?
答:可以使用Metamask连接到公共节点、也可以链接到使用Geth搭建的本地节点,或者在Javascript VM中模拟的内存节点。
问:什么是DApp,它与App有什么不同?有什么不同?
答:App通常包含一个客户端,这个客户端会与一些中心化的资源(由一个组织拥有)进行通信,通常客户端通过一个中间层连接到中心化的数据层,如果中心化的数据层中的信息丢失,不能很轻松地恢复。
DApp表示去中心化应用程序。 DApps通过智能合约与区块链网络进行交互。 DApp使用的数据驻留在合约实例中。
中心化数据可能比去中心化数据更容易受到破坏。
问:DApp的前端是否局限于某些技术或框架?
答:不受限制。可以使用任何技术来开发DApp的前端,比如HTML,CSS,JS,Java,Python…
问:前端用什么库连接后端(智能合同)?
答:Web3.js库。
问:在DApp的前端需要哪些东西才能与指定的智能合约进行交互?
答:合约的ABI和字节码。
问:ABI有什么作用?
答:ABI是合约的公开接口描述对象,被DApps用于调用合约的接口。
问:字节码有什么作用?
答:节点上的EVM只能执行合约的字节码。
问:为什么要使用BigNumber库?
答:因为Javascript不能正确处理大数。
问:为什么需要检查在Web DApp代码的开始部分是否设置了web3提供器(Provider)?
答:因为Metamask会注入一个web3对象,它覆盖其他的web3设置。
问:为什么要使用web3.js版本1.x而不是0.2x.x?
答:主要是因为1.x的异步调用使用Promise而不是回调,Promise目前在javascript世界中
是处理异步调用的首选方案。
问:如何在web3 1.x中列出账户?
答:web3.eth.getAccounts
问:.call和.send有什么区别?
答:.send发送交易并支付费用,而.call查询合约状态。
问:这样发送1个以太对吗:.send({value:1})?
A:不对,这样发送的是1 wei。 交易中总是以wei为单位。
问:那么为了发送1个以太,我必须将这个值乘以10^18?
答:可以使用web3.utils.toWei(1,‘ether’)。
问:调用.send()时需要指定什么?
答:必须指定from字段,即发送账户地址。 其他一切都是可选的。
问:web3.eth.sendTransaction()的唯一功能是将以太发送到特定的地址,这个说法是否正确?
答:不对,也可以用它调用合约方法。
问:你是否知道以太坊的可扩展性解决方案?
答:2层协议。可能的解决方案是状态通道(state channels)和Plasma。
Solidity
问:Solidity是静态类型的还是动态类型的语言?
答:它是静态类型语言,这意味着类型在编译时是已知的。
问:Solidity中与Java“Class”类似的是什么?
答:合约。
问:什么是合约实例?
答:合约实例是区块链上已部署的合约。
问:请说出Java和Solidity之间的一些区别。
答:Solidity支持多重继承,但不支持重载。
问:你必须在Solidity文件中指定的第一件事是什么?
答:Solidity编译器的版本,比如指定为^ 0.4.8。 这是必要的,因为这样可以防止在使用其他版本的编译器时引入不兼容性错误。
问:合约中包含什么?
答:主要由存储变量、函数和事件组成。
问:合约中有哪些类型的函数?
答:有构造函数、fallback函数、修改合约状态的函数和只读的constant函数。
问:如果我将多个合约定义放入单个Solidity文件中,我会得到什么错误?
答:将多个合约定义放入单个Solidity文件是完全正确的。
问:两个合约之间交互的方式有哪些?
答:一个合约可以调用另一个合约,也可以继承其他合约。
问:当你尝试使用部署一个包含多个合约的文件时会发生什么?
答:编译器只会部署该文件中的最后一个合约,而忽略所有其他合约。
问:如果我有一个大项目,我需要将所有相关的合约保存到一个文件中吗?
答:不需要。可以使用import语句导入其他合约文件,例如import “./MyOtherContracts.sol”;。
问:我只能导入本地合约文件吗?
答:还可以使用HTTP协议导入其他合约文件,例如从Github导入:import “http://github.com/owner/repo/path_to_file”;。
问:EVM的内存分成了哪些部分?
答:它分为Storage、Memory和Calldata。
问:请解释一下Storage。
答:可以把它想象成一个数据库。 每个合约管理自己的Storage变量。 它是一个键-值数据库(256位键值)。
就每次执行使用的gas而言,在Storage上读取和写入的成本更高。
问:请解释一下Memory。
答:这是一个临时存储区。 一旦执行结束,数据就会丢失。 可以在Memory上分配像数组和结构这样复杂的数据类型。
问:请解释一下Calldata 。
答:可以把calldata视为一个调用堆栈。 它是临时的、不可修改的,用来存储EVM的执行数据。
问:哪些变量存储在Storage,那些变量存储在Memory?
答:状态变量和局部变量(它们是对状态变量的引用)存储在Storage区域, 函数参数位于Memory区域。
转自:csdn论坛 ,
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
众所周知,Vue项目采用了数据双向绑定和虚拟DOM基础,在数据驱动代替DOM频繁渲染已经算是非常高效了,对开发者而言已经非常优化了,那为什么还会有Vue性能优化这一说呢?
因为目前Vue 2.x使用了webpack等第三方打包构建工具,并且支持其他第三方的插件,我们在项目中使用这些工具时可能不同的操作在运行或打包效率上会有不同的效果,下面就来详细说明优化的方向。
1 v-if 和 v-show 的使用
v-if 为false的时候不会渲染DOM到视图,为true的时候才会渲染到视图;
v-show 不管初始条件是什么,元素总是会渲染到视图,只是简单地基于 CSS 的 display 属性进行切换。
最佳实践:频繁切换显示隐藏的元素采用v-show,很少改变使用v-if
2 computed 和 watch 区分使用
computed: 是计算属性,依赖其它属性值,并且 computed 的值有缓存,只有它依赖的属性值发生改变,下一次获取 computed 的值时才会重新计算 computed的值;
watch: 更多的是「观察」的作用,类似于某些数据的监听回调 ,每当监听的数据变化时都会执行回调进行后续操作;
最佳实践:当我们需要进行数值计算,并且依赖于其它数据时,应该使用 computed,因为可以利用 computed 的缓存特性,避免每次获取值时,都要重新计算;当我们需要在数据变化时执行异步或开销较大的操作时,应该使用 watch,使用 watch 选项允许我们执行异步操作 ( 访问一个 API ),限制我们执行该操作的频率,并在我们得到最终结果前,设置中间状态。这些都是计算属性无法做到的。
3 v-for 遍历必须为 item 添加 key,且避免同时使用 v-if
现在不加key一般会报错的,添加key可以方便 Vue内部机制精准找到该条列表数据。当更新时,新的状态值和旧的状态值对比,较快地定位到 diff
v-for比 v-if 优先级高,如果每一次都需要遍历整个数组,将会影响速度,尤其是当之需要渲染很小一部分的时候,必要情况下应该替换成 computed属性。
4 纯显示长列表性能优化
对于只用来展示用的数据,不需要做vue做数据劫持,只需要冻结这个对象即可:
export default { data () { return { users: [] } }, created () { axios.get('/api/users').then((res)=>{ this.users = Object.freeze(res.data.users) }) } }
5 事件的销毁
Vue 组件销毁时,会自动清理它与其它实例的连接,解绑它的全部指令及事件监听器,但是仅限于组件本身的事件。 如果在 js 内使用 addEventListene 等方式是不会自动销毁的,我们需要在组件销毁时手动移除这些事件的监听,以免造成内存泄露,如:
created() { addEventListener('click', this.click, false) }, beforeDestroy() { removeEventListener('click', this.click, false) }
6 图片资源懒加载
使用vue-lazyload插件:
安装
npm install vue-lazyload --save-dev
1
man.js 引用
import VueLazyload from 'vue-lazyload' Vue.use(VueLazyload) // 或自定义 Vue.use(VueLazyload, { preLoad: 1.3, error: 'dist/error.png', loading: 'dist/loading.gif', attempt: 1 })
修改img标签
<img v-lazy="/static/img/1.png">
1
7 路由懒加载
Vue 是单页面应用,可能会有很多的路由引入 ,这样使用 webpcak 打包后的文件很大,当进入首页时,加载的资源过多,页面会出现白屏的情况,不利于用户体验。如果我们能把不同路由对应的组件分割成不同的代码块,然后当路由被访问的时候才加载对应的组件,这样就更加高效了。这样会大大提高首屏显示的速度,但是可能其他的页面的速度就会降下来。
const Foo = () => import('./Foo.vue') const router = new VueRouter({ routes: [ { path: '/foo', component: Foo } ] })
8 第三方插件按需引入
我们在使用第三方库的时候,最好是按需引入而不是全局引入,因为第三方库的插件比较多全部引入会打包比较慢,如Element UI、Ant Design of Vue等UI库:
按需引入
import Vue from 'vue'; import { DatePicker } from 'ant-design-vue'; Vue.use(DatePicker);
1
2
3
全局引入
import Antd from 'ant-design-vue'; Vue.use(Antd);
1
2
9 优化无限列表性能
如果你是在渲染带无限滚动加载的列表时,那么需要采用 窗口化 的技术来优化性能,只需要渲染少部分区域的内容,减少重新渲染组件和创建 dom 节点的时间。 你可以参考以下开源项目 vue-virtual-scroll-list 和 vue-virtual-scroller来优化这种无限列表的场景的。
大家自己去Github看使用说明吧。
10 服务端渲染 SSR or 预渲染
一般单页应用是在浏览器端完成页面渲染的,数据是发请求从后台拿过来的;而服务器端渲染SSR是页面元素的结构(HTML)是在服务器端就已经构建好的,直接把整个页面返回到客户端的。
那SSR有什么优缺点呢:
更好的SEO:网络爬虫可以直接爬取页面信息利于被搜索引擎收录,而ajax异步请求的内容不会被收录,所以通过SSR渲染的完整的页面信息更利于SEO;
支持的钩子函数只支持 beforCreate 和 created,服务器需要处于Node Server环境;
需要更高的服务器配置:因为它包含了数据处理和页面渲染,所以服务器开支变大
如果对首屏加载速度要求比较高或对SEO有要求的可以采用SSR渲染。
转自:csdn论坛
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
正如Redux一样,当你不知道是否需要Vuex那就是不需要。不要因为想用Vuex而使用它。
用过Vue的人都知道,Vuex是Vue的一个全局状态管理模块,它的作用是多个组件共享状态及数据,当某个组件将全局状态修改时,在绑定了该状态的另一个组件也将响应。实际上可以将Vue理解为一个function,在Vue的作用域中有一个数据代理,在每个Vue的实例中都能对其读和写
我们都知道Vue的数据驱动原理是用Object.defineProperty()进行数据代理,在setter中对数据绑定的view进行异步响应(vue3.0则是使用proxy)
通过查看Vuex源码可知Vuex的核心原理就是在Vue的beforeCreate钩子前混入(mixin)Vuex,并在init中将$store属性注册到Vue中
为了使案例更具体,我这还是简单使用脚手架搭了个项目(可参考另一篇文章),虽然只有两个组件,但是能清晰的理解其用法,我的src目录如下,除了最基础的App.vue和main.js外只有两个组件和一个store
先说明一下两个组件的作用,第一个组件是输入框,在里面输入字符,在二个组件div中显示,就是这么简单
首先我们使用常规方式(EventBus)实现一下,这里只需要在mainjs中创建一个vue实例,然后注册在vue中就可以通过事件emit和on来进行组件通信
main.js
import Vue
from 'vue'
import App
from './App'
Vue.prototype.$eventBus = new Vue()
new Vue({
el: '#app',
components: {App},
template: '<App/>'
})
<template>
<div>
{{
val
}}
</div>
</template>
<script>
export default {
name: "divComp",
data () {
return {
val: ''
}
},
mounted () {
this.$eventBus.$on('changeVal', (e) => {//监听输入事件通过eventBus传递信息
this.val = e
})
}
}
</script>
<style
scoped>
</style>
如果到这一步,你仍然感觉难度不大,那么恭喜你,Vuex的使用已经掌握了一大半了
下面,我们来说说actions,在说actions之前,我们先回顾一下mutations,mutations中注册了一些事件,在组件中通过emit对事件进行触发,达到处理异步且解耦的效果,然而官方并不推荐我们直接对store进行操作
官方对actions的说明是:Action 类似于 mutation,不同在于1.Action 提交的是 mutation,而不是直接变更状态。2.Action 可以包含任意异步操作。
也就是说,我们要把组件中的emit操作放到actions中,而在组件中通过某些方式来触发actions中的函数间接调用emit,此时,为了让action更直观,我们添加一个清除输入框字符的方法,当点击清除按钮时清除state.val
在输入框组件中将value绑定到state上
<template>
<input type="text" @input="inputHandler" :value="this.$store.state.val" />
</template>
<script>
export default {
name: "inputComp",
methods: {
inputHandler(e) {
this.$store.dispatch("actionVal", e.target.value);
},
},
};
</script>
<style
scoped>
</style>
在另一个显示数据的组件中新增删除按钮并绑定删除事件,通过dispatch告知store并通过emit操作state
<template>
<div>
<button @click="clickHandler">清除</button>
<span>{{ this.$store.state.val + this.$store.getters.getValueLength }}</span>
</div>
</template>
<script>
export default {
name: "divComp",
methods: {
clickHandler(){
this.$store.dispatch('actionClearVal')
}
},
};
</script>
<style
scoped>
</style>
最后在store中新建删除的actions和mutations
import Vue
from "vue";
import Vuex
from "vuex";
Vue.use(Vuex);
const state = {
val: ''
}
const mutations = {
changeVal(state, _val) {
state.val = _val
},
clearVal(state, _val) {
state.val = ''
}
}
const actions = {
actionVal(state, _val) {
state.commit('changeVal', _val)
},
actionClearVal(state) {
state.commit('clearVal')
}
}
const getters = {
getValueLength(state) {
return `长度:${state.val.length}`
}
}
export default new Vuex.Store({
state,
mutations,
actions,
getters
})
最终效果如下:
到这里为止,Vuex的基本用法就介绍完毕了。
然而除此之外,Vuex官方还提供了辅助函数(mapState,mapMutations,mapGetters,mapActions)和Modules(store的子模块,当有许多全局状态时,我们为了避免代码臃肿,就可以将各个store分割成模块)方便我们书写
下面我们用辅助函数重新实现一下上述功能
输入框:
<template>
<input type="text" @input="inputHandler" :value="value" />
</template>
<script>
import { mapState, mapMutations } from "vuex";
export default {
name: "inputComp",
computed: {
...mapState({ value: "val" }),
},
methods: {
...mapMutations({ sendParams: "changeVal" }), // sendParams用来传递参数,先把sendParams注册到mutations上,输入时触发sendParams
inputHandler(e) {
this.sendParams(e.target.value);
},
},
};
</script>
<style
scoped>
</style>
显示框:
<template>
<div>
<button @click="clickHandler">清除</button>
<span>{{ value + valueLength }}</span>
</div>
</template>
<script>
import { mapState, mapGetters, mapActions } from "vuex";
export default {
name: "divComp",
computed: {
...mapState({ value: "val" }),
...mapGetters({ valueLength: "getValueLength" }),
},
methods: {
...mapActions({ clickHandler: "actionClearVal" }),
},
};
</script>
<style
scoped>
</style>
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
文章目录
一.函数防抖
二、函数节流
1.时间戳实现
2.定时器实现
3.用节流优化防抖(定时器+时间戳)
三、总结
四、例子
一.函数防抖
当持续触发事件时,并不执行事件处理函数,一定时间段内没有再触发事件,事件处理函数才会执行一次;如果设定的时间到来之前,又一次触发了事件,就重新开始延时。
function debounce(fn, delay) {
// 定时器
let timer = null
// 将debounce处理结果当作函数返回
return function () {
// 保留调用时的this上下文
let context = this
// 保留调用时传入的参数
let args = arguments
// 每次事件被触发时,都去清除之前的旧定时器
if(timer) {
clearTimeout(timer)
}
// 设立新定时器
timer = setTimeout(function () {
fn.apply(context, args)
}, delay)
}
}
当持续触发事件时,保证一定时间段内只调用一次事件处理函数。
3.用节流优化防抖(定时器+时间戳)
防抖的问题在于如果用户的操作十分频繁——他每次都不等 设置的 delay 时间结束就进行下一次操作,于是每次都为该用户重新生成定时器,回调函数被延迟了不计其数次。 频繁的延迟会导致用户迟迟得不到响应,用户同样会产生“这个页面卡死了”的观感。
用节流来优化,保证在一定时间段内会调用一次事件处理函数。
function throttle(fn, delay) {
// last为上一次触发回调的时间, timer是定时器
let last = 0, timer = null
// 将throttle处理结果当作函数返回
return function () {
// 保留调用时的this上下文
let context = this
// 保留调用时传入的参数
let args = arguments
// 记录本次触发回调的时间
let now = +new Date()
// +是一元操作符,利用js隐式转换将其他类型变为数字类型
// 判断上次触发的时间和本次触发的时间差是否小于时间间隔的阈值
if (now - last < delay) {
// 如果时间间隔小于我们设定的时间间隔阈值,则为本次触发操作设立一个新的定时器
clearTimeout(timer)
timer = setTimeout(function () {
last = now
fn.apply(context, args)
}, delay)
} else {
// 如果时间间隔超出了我们设定的时间间隔阈值,那就不等了,无论如何要反馈给用户一次响应
last = now
fn.apply(context, args)
}
}
}
三、总结
函数防抖:将几次操作合并为一此操作进行。原理是维护一个计时器,规定在delay时间后触发函数,但是在delay时间内再次触发的话,就会取消之前的计时器而重新设置。这样一来,只有最后一次操作能被触发。
函数节流:使得一定时间内只触发一次函数。原理是通过判断是否到达一定时间来触发函数。
区别: 函数节流不管事件触发有多频繁,都会保证在规定时间内一定会执行一次真正的事件处理函数,而函数防抖只是在最后一次事件后才触发一次函数。
场景:比如在页面的无限加载场景下,我们需要用户在滚动页面时,每隔一段时间发一次 Ajax 请求,而不是在用户停下滚动页面操作时才去请求数据。这样的场景,就适合用节流技术来实现。
转自:csdn
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
异常包括的主要关键字有try{}catch(){}finally{} throw和throws五个关键字 。
下面我们来细说一下这五个关键字分别有什么用。
try catch关键字 这两个关键字是连用的
1.如果try块中的语句正常执行完毕,不会发生异常则catch块中的语句都将会被忽略。
2.如果try语句块在执行中遇到异常。并且这个异常与catch中声明的异常类型相匹配,那么在try块中其余剩下的代码都将被忽略。
3.如果try语句块在执行过程中遇到异常,而抛出的异常在catch块中没有被声明,那么程序立刻退出。
finally关键字这个关键字中的代码总能被执行(怎么我都要执行 )
1.只要try中所有语句正常执行完毕,那么finally块就会被执行。
2.如果try语句块在执行过程中碰到异常,无论这种异常能否被catch块捕获到,都将执行finally块中的代码。
注:try—catch—finally结构中try块是必需的catch和finally块为可选,但两者至少须出现其中之一。
如果catch中存在return,finally也会执行只不过执行的顺序有一定差异 ,先执行catch里的代码块,之后执行finally里的代码块,最后执行return语句。
throw关键字抛出异常
throws关键字声明捕捉异常
那么throw和throws有什么区别呢
1.作用不同:throw用于在程序中抛出异常;throws用于声明在该方法内抛出异常。
2.使用的位置不同:throw位于方法体内部,可以作为单独语句使用;throws必须跟在方法参数列表的后面,不能单独使用。
3.内容不同:throw抛出一个异常对象,而且只能有一个;throws后面跟异常类,而且可以跟多个异常类。
知道了这五个关键字的用法下面我们来说一下几个常用的异常代码:
1.ArithmeticException 试图除以0。
2.NullpointerException 当程序访问一个空对象的成员变量或方法,访问一个空数组的成员时发生。
3.ClassCastException 发生多态后,吐过强制转换的并不是父类的子类时发生。编译的时候可以通过,以为编译的时候并不会检查类型转换的问题。
4.ArraylndwxOutOfBoundsException 访问的元素下标超过数组长度
5.NumberFormatException 数字格式异常。
6.Exception 一般的异常都包括。
转自:csdn
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
ES6中的let和const和解构赋值
什么是ES6?
ES6, 全称 ECMAScript 6.0 ,是 JavaScript 的下一个版本标准,2015.06 发版。
为什么要使用ES6?
每一次标准的诞生都意味着语言的完善,功能的加强。js语言本身也有一些令人不满的地方
1.变量提升特性增加了程序运行的不可预测性 。
变量提升可以简单看以下代码了解下:
console.log(a);
var a=1;
//console.log(a)会输出undefined
这段代码也可以这样表示
var a;
console.log(a);
a=10;
//依旧输出undefined
这就是变量提升!
2.语法过于松散,实现相同的功能,不同的人可以会写出不同的代码,阅读性较低。
所以:ES6 ,目标是使JavaScript语言可以用来编写复杂的大型应用程序,成为企业级开发语言。我们没有理由不去学习ES6。
let关键字
ES6中新增的用于声明变量的关键字。主要是替代var。
特征:1.let声明的变量只在所处的块级有效,具有块级作用域! 在ES6之前JS只有全局作用域和局部作用域。
块级作用域:通俗来讲就是在一对大括号中产生的作用域,块级作用域中的变量只能在大括号中访问,在大括号外面是访问不到的。
可以看以下代码:
if(true){
let a=10;
console.log(a);//输出10
}
console.log(a);//报错提示a没有定义
{
let b=10;
console.log(b);//输出10
}
console.log(b);//报错提示b没有定义
if(true){
let c=20;
console.log(c)//输出20
if(true){
let d=30;
console.log(c)//输出 20
}
console.log(d);//报错d没有定义
}
在for循环中也起到作用,根据不同的需求选择let和var!
例如:
for(var i=0;i<10;i++){}
console.log(i) //输出10
for(let j=0;j<10;j++){}
console.log(j) //报错 j没有定义
好处:在业务逻辑比较复杂的时候,可以放在内层变量覆盖外层变量!
2.存在let 一开始就会形成封闭的作用域 使用let命名声明变量前 ,变量不可用,必须先声明后使用,不存在变量提升
例如:
if(true){
console.log(temp);//报错
let temp=1;
}`
3.let 不允许重复声明 在一个作用域内。
例如:
if(true){
let temp;
console.log(temp);//报错Identifier 'temp' has already been declared
let temp=1;
}
if(true){
var temp=10;
let temp=5;
console.log(temp);//报错 错误和上面一致
}
但是不在一个作用域内可以 例如:
{
let x=10;
console.log(x);//输出10
}
{
let x=5;
console.log(5);//输出5
}
const关键字
const一般用来声明常量,声明一个只读的常量。
特征:1.一旦声明其值不能改变必须立即初始化
例如:
const a; //这样什声明会直接报错!!!
1
这样声明没有初始化会直接报错!
2.对于对象:存的不是对象的本身, 而是对象的引用, 引用地址 ,地址不变, 对象可拓展!
例如:
const foo={y:10};
foo.x=100;
console.log(foo.x);//输出100
1
2
3
对象可以扩展
但是对象不能改变
例如:foo={n:1000}; 会报错!
作用域:
var v1=100;
function f1(){
console.log(v1,v2); //undefined no defined
var v1=110;
let v2=200;
function f2(){
let v3=300;
console.log(v1,v2,v3);//110 200 300
}
f2();
console.log(v1,v2,v3);// 110 200 no defined
}
f1();
console.log(v1,v2,v3);// 100 no defined no defined
可以向外面作用域找 不可以向里面作用域找 内层变量可能会覆盖外层变量
let和var的本质区别:浏览器的顶层对象为window Node的为global,var定义的变量会关联到顶层对象中,let和const不会!
例如:
var a =100;
console.log(window.a); // 100
let b=100;
console.log(window.b); //undefined
1
2
3
4
如何选择const和let:数据需要变化用let 数据不需要变化用const
解构赋值:ES6中允许从数组中提值,按照对应位置,对变量赋值,对象也可以实现解构!
例如:
{
let a,b,c;
[a,b]=[1,2];
console.log(a,b,c); //输出 1 2 undefined
}
{
let a,b,c;
[a,b,...c]=[1,2,3,4,5,6];
console.log(a);//输出1
console.log(b);//输出2
console.log(c);//输出[3,4,5,6]
}
{
let a,b,c;
[a,b,c=3]=[1,2];
console.log(a,b,c);//输出1 2 3
}
{
let a,b;
[a,b]=[1,2];
[a,b]=[b,a]
console.log(a,b);//输出 2 1
}
{
let a,b;
({a,b}={a:1,b:2})
console.log(a,b);//输出 1 2
}
{
function fun(){
return [1,2,3,4,5,6]
};
let a,b;
[a,,,,b]=fun();
console.log(a,b);//输出1 5
}
{
let o={p:42,q:true};
let {p,q}=o;
console.log(p,q);//输出 42 true
}
{
let {a=10,b=5}={a:3};
console.log(a,b);//输出 3 5
}
{
let metaData={
title:'abc',
test:[{
title:'test',
desc:'description'
}]
}
let {title:esTitle,test:[{title:cnTitle}]}=metaData;
console.log(esTitle,cnTitle);//输出abc test
}
解构赋值表达式右边的部分表示解构的源;解构表达式左边的部分表示解构的目标,如果左右两边对比成功就返回右边的值,如果没有对比成功就会undefined返回原来的值
除此之外还可以返回一些函数和方法
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
零基础如何快速入「]前端?这个问题往往是没有基础会遇到的,想要快速入「门前端开发,简单来说就是要把基础的知识点掌握熟练,然后由浅入深的去学习,在这里根据我过来的经验,为大家简单介绍一下零基础如何快速入门前端。
举个可能不太恰当的例子:前端就好比如盖房子,html就充当 了房子结构这部分,也是房子的基础。css呢, 就好比咱们房子的装修,墙面什么颜色,什么风格,什么地板等等,这些给房子改变风格,样式的就是css。而Java呢,就好比这个房子的功能,房子需要制冷吧,需要暖气吧,也需要上下水吧。这些功能性的就相当于是Java。
一、前端工具(dreamwear/sublime/Photoshop/SVN等)
二、零基础入门(HTML,CSS)
1、前端开发概况、代码入门
页面基本结构、文档声明、编码声明、css语法、style属性、link和style标签、id属性、基本样式、Border 、Background、 Font、盒模型、文本设置等等。
2、常用标签集合
header、article、aside、section、footer、nav、h1-h6、p、ul、ol、li、img、dl、dt、dd…绝对路径、相对路径、标签语义化、标签嵌套规范、SEO…
3、常用选择器&标签类型划分
d、class、类型选择、包含选择、群组选择、通配符、选择器优先级、标签样式初始化订制方案、超链接及伪类划分、标签类型划分及特性、inline、inline-block、block…
4、浮动进阶
浮动的作用、浮动的特性、文档流、浮动的各种问题、clear、BFC(块级格式化上下文)、触发BFC的条件、Haslayout、Haslayout的触发条件…
5、定位
relative相对定位、Absolute绝对定位、Absolute绝对定位、Fixed 固定定位、inherit 继承、static静态定位、默认值、zIndex层级问题、margin负值、透明度…
6、表格和表单
表格标签、表格样式重置、单元格合并、表单元素、表单相关的属性操作、表单默认样式初始…
7、兼容性问题处理
兼容性问题总结、浮动在IE6,7下的各种问题、表单在低版本IE的问题、处理低版本IE对新增标签的支持、CssHack、条件注释语句、PNG问题、透明度的问题、固定定位在IE低版本的处理方式…
8、整站进阶
样式规划、favicon、Css Sprite、Data URI、隐藏元素、测试工具使用、滑动门、等高布局、三列布局、未知宽高图片在容器内水平垂直居中、文本水平垂直居中、多行文本水平垂直居中…
9、css3入门
transition、属性选择器、nth-of-type、nth-child、backgroundSize、box-sizing、圆角,盒模型阴影、文字阴影、rgba、表单高级、H5表单新增属性、E:not(s)、E:target、E::selection、
10、移动端布局
测试环境Emulation、viewport、window.devicePixelRatio、物理分辨率、Media Queries、rem、window.screen、移动端布局相关问题、window.deviceorientationevent、横竖屏判断…
11、Animation和Transform
浏览器前缀、keyFrames、Animation调用、播放次数设置、动画偶数次调用顺序、Animation的问题、无缝滚动、动画播放|暂停、rotate旋转、deg、skew斜切、scale缩放、translate位移、transform-origin、transform的执行顺序问题…
12、Bootstrap前端开发框架
Html语法规范、CSS语法规范、Less 和 Sass 中的嵌套、class 命名、选择器、Normalize.css、栅格系统、排版、代码、响应式工具…
另外关于零基础如何快速入门前端的问题,项目实战这一点很重要,一定要学以致用,我的建议是,只有在实战项目中多加练习才能真正的掌握这门技术!
转自:csdn; 作者:hugo233
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
!DOCTYPE html
功能是:告知浏览以哪个版本来解析HTML的元素
注:必须放在第一行
DOCTYPE 文档声明定义
document 文档
type 类型
charset
utf-8
字符编码集
告诉浏览器用哪一个版本来解析文本(包括标点符号,文字)
viewport
视口(可视窗口)
title
标签页标题
HTML元素的组成部分
元素:起始标记、内容和结束标记
某些元素的起始标记内有属性
属性:属性名和属性值
例如:
<a href="/classroom/17">班级</a>
1
起始标记:
结束标记:
内容:班级
属性:href="/classroom/17"
属性名:href
属性值:"/classroom/17"
空元素
类似img元素
<img src="" alt="">
1
没有元素内容和结束标记,称之为:空元素、自闭合元素
乱序铭文
功能:批量生成文本
书写格式:lorem数量(单词个数)
p标签
p标签不能包含(嵌套)p标签,也不能包含标题、div,语义化标签
解析
将我们写出的代码,转换成计算机可以看懂的语言
渲染
再将解析好的语言,通过浏览器渲染展示出来,给用户看。
HTML
是用于定义文档的结构内容(标题、图片等)
HTML英文全称:Hyper Text Markup Language
中文全称:超文本标记语言
CSS
用于定义HTML文档的样式(外观)
CSS英文全称:Cascading Style Sheets
中文全称:层叠样式表
语义化结构
header 页面的头部或者某个区域的头部,一个页面可以使用多个header元素
nav 表示导航栏
article 代表文档、页面或其他可独立部分,常用于定义一篇日志、一条新闻或用户评论。
aside 用于表示当前页面或文章相关的附属信息,可包含该页面或内容相关的引用、侧边栏、广告、导航条等
section 用于表示一个整体的一部分主题
footer 用于表示页面或者某个区域的脚注,可以包含所有放在页面底部的内容
div与语义化结构的区别
div与语义化结构标签的功能是一样的,但是使用语义化结构标签可以让页面结构更加清晰。
a标签
元素书写格式
<a href="目标">内容</a>
1
href属性
页面地址(路径)
多个页面中相互跳转
锚点
可以在同一个页面之间,相互跳转
先将要跳转的位置加上id属性
<h1 id="title2">标题二</h1>
1
将#+属性名
<a href="#title2">跳转到标题二</a>
1
功能链接
打电话
<a href="tel:12345678910">给我打电话</a>
1
发邮件
<a href="mailto:123456789@163.com">给我发邮件</a>
1
返回顶部
<a href="#">返回顶部</a>
1
a标签的打开方式
书写方式:
<a target="_blank" href="目标"></a>
1
属性 target
属性值
_blank 新页面打开
_self 当前页面打开(默认值)
link外部引用的好处
批量修改
复用
绝对路径和相对路径
绝对路径
从根目录开始写,写到要找文件的位置
当网站部署到服务器后,网站中的所有资源都可以通过一个地址(路径)访问
书写格式:协议://域名/目录
使用场景:
访问站外资源时,只能使用绝对路径
访问站内资源时,若网站已部署到服务器,可以使用绝对路径,并可以省略协议和域名。推荐使用相对路径
相对路径
相对路径是相对于当前资源的位置,只能用于访问站内资源
相对路径的书写格式为:./路径
./ 表示当前资源所在的目录,必须作为相对路径的开始,可省略
…/ 表示返回上一级目录 (…/…/可以返回上两级目录,写几次就可以返回几次
转自:csdn 作者:小王小王 辅助在行
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
HTML概念和元素(标签)
什么是HTML
HTML(Hyper Text Markup Language),中文译名为超文本标记语言,它包括一系列标签,通过这些标签可以将网络上的文档格式统一,使分散的Internet资源连接为一个逻辑整体。简单来说,就是我们用它所包含的一系列标签来定义网页的布局结构。
什么是HTML标签(元素)
HTML 文档是由 HTML 元素定义的,元素由三部分组成:开始标签、元素内容、结束标签。
HTML 元素以开始标签起始,以结束标签终止,元素的内容是开始标签与结束标签之间的内容。在VSCode中,使用标签只需要输入需要使用的标签名,再按Tab键,编辑器会自动补齐开始标签和结束标签的样式。
温馨提示:
1.标签的括号我们用的是尖括号,这也是HTML代码和CSS(层叠样式表)代码的区别。
2.HTML 标签对大小写不敏感,也就是说不管我们用大写还是小写浏览器都能成功识别,但是为了统一标准,最好还是写小写。
元素的层次结构
大多数 HTML 元素可以包含其他 HTML 元素,形成嵌套结构
如图,div元素内部包含一个p元素,形成嵌套。在嵌套结构中,p的上一级元素是div,我们称div是p的父元素,p是div的子元素,他们之间是父子级关系。
若是如图这样body、div、p三个元素嵌套,p的上一级元素是div,div的上一级元素是body,那么div是body的子元素,body是div的父元素,body和div是父子关系。而p和body中间隔了一个div,那么p就是body的后代元素,body是p的祖先元素,他们是祖先和后代的关系。
若是两个元素拥有一个共同的父元素,也就是两个元素的上一级元素是同一个,那么这两个元素互为兄弟元素。
需要注意的是,两个元素之间不能相互嵌套
p的起始标签在div内部,结束标签却在div外部,这样的嵌套结构是错误的,浏览器在解析的时候会自动在p的起始标签后补上结束标签,在结束标签前面补上起始标签。
当我们打开浏览器检查器之后就会发现div和p的层次结构已经发生了改变。
元素的属性
属性是元素的附加信息,比如超链链接的地址就是元素的附加信息,属性一般写在元素的起始标签里。
这是一个a标签,起始标签的href="http://www.baidu.com"就是a标签的属性,点击‘百度’后自动跳转属性里的网址。属性由属性名和属性值两部分组成,‘href’是属性的属性名,后面的网址是属性值,属性值要用引号括起来。
空元素(自闭合元素)
空元素没有元素内容和结束标签,只有起始标签。空元素内可以加上属性,例如插入图片的img标签
img标签没有元素内容和结束标签,起始标签内有属性,属性值是图片地址。
一般情况下,图片用空标签,音频视频不适用空标签
HTML注释
注释是对代码功能的描述,一般是写给开发者和维护者看的,浏览器并不会解析注释里的内容。因为在代码编写的过程中,代码繁多杂乱,写上注释能帮助我们快速理解当前代码的功能,给维护提供方便。
VSCode注释的写法:在尖括号内写上 !–和--,中间写上注释的内容,或者选中想要注释的行,按下快捷键CTRL+?。
语义化标签和div
div是无语义标签,就是没有含义的标签。而所谓语义化标签,就是有含义的标签,一看就知道其内部含义。我们平时使用语义化标签和div来划分区域,他们在功能上是没有任何区别的,只是语义化标签能帮助开发者和维护者清晰地理解划分的每个区域都是用来干嘛的。在HTML5之前都是用div来划分区域,就会导致整篇代码全是div,看得人眼花缭乱不易于阅读,语义化标签的出现就能解决这个问题。
在HTML5中新增了几个语义化标签:
header:用于表示页面的头部
nav:表示导航栏
article:表示文章或其他可独立存在的页面
section:表示一个整体的一部分主题
aside:表示跟周围主题相关的附加信息
footer:表示页面或某个区域的注脚
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
JS学习笔记
js和java的异同点
变量声明
函数声明
js中的变量提升和函数提升
为什么有变量提升
总结
js和java的异同点
首先,js的语法和kottlin的语法有些相似。比如var,方法声明用
function 方法名称 (参数名称...){
//方法内部逻辑
}
还有变量类型声明 :
数据类型 : 变量名=值
区别:一:js的数据类型和java类似。只不过js中的数据类型number将java中的int,double,float整合了。
二:js中可以不用声明变量类型。变量不声明数据类型的话,那么他的类型取决于当前的值是什么数据类型。举例:
var num=0;
num-"lyyyyyyyyyyyyyy";
num=[];
num={};
三:js中的类型判断:
判断基本类型,返回一个字符串
1
console.log(typeof '');//string
console.log(typeof []);//object
console.log(typeof {});//object
console.log(typeof 1);//number
console.log(typeof null);//object
console.log(typeof undefined);//undefined
console.log(typeof true);//boolean
console.log(typeof function(){});//function
console.log(typeof /\d/);//object
检查某个对象属于哪个构造函数,返回true/false
1
function A(){};
function B(){};
let a = new A();
console.log(a instanceof A);
console.log(a instanceof B);
console.log([] instanceof Array);//true
console.log({} instanceof Object);//true
console.log(/\d/ instanceof RegExp);//true
console.log(function(){} instanceof Object);//true
console.log(function(){} instanceof Function);//true
变量声明
js的变量声明其实大体上可以分为三种:var声明、let与const声明和函数声明。
函数声明
doSomething();
function doSomething() {
console.log('doSomething');
}
var foodoSomething= 2;
你觉得上面会输出什么?TypeError吗?其实输出的结果是foo。这就引出了我们的问题了,当函数声明与其他声明一起出现的时候,是以谁为准呢?答案就是,函数声明高于一切,毕竟函数是js的第一公民。
那么,下面的例子呢?
doSomething();
function doSomething() {
console.log('1');
}
function doSomething() {
console.log('2');
}
当出现多个函数声明,那怎么办呢?以上代码输出结果为2。
因为有多个函数声明的时候,是由最后面的函数声明来替代前面的。
domeSomething();
var domeSomething= function() {
console.log('domeSomething');
}
var domeSomething = function() {}这种格式我们叫做函数表达式。
它其实也是分为两部分,一部分是var foo,而一部分是foo = function() {},参照例2,我们可以知道,这道题的结果应该是报了TypeError(因为foo声明但未赋值,因此foo是undefined)。
js中的变量提升和函数提升
在js中对变量进行操作后打印值经常会出现undefined的现象。其实原因是因为js中有一个叫做变量提升的功能。举例:
1
var data="lyyyyy";
getData();
function getData(){
//第一次打印
console.log("data值为: ", data);
var data="yyyyyyy";
//第二次打印
console.log("data值为: ", data);
}
打印的值第一个为undefined,而第二个打印的值为yyyyy.
原因:
在执行getData()方法的时候会在函数内部首先将变量的声明提升到第一步。
然后再声明函数内部的函数(如果函数内部有函数的话)。
之后才会按照方法内部的逻辑先后顺序执行代码。前两步只是声明!!!
看到这里应该就已经知道为什么会有上面那样的结果了。
实际的方法内部代码执行顺序应该是这样的:
function getData(){
//一。声明变量
var data;
//二。声明函数(如果函数内部有函数的话)
//三。按照代码的顺序执行
console.log("data值为: ", data);
data="yyyyyyy";
//第二次打印
console.log("data值为: ", data);
}
看到拆分后的代码执行顺序对结果也就不迷茫了。
为什么有变量提升
那么为什么会出现变量提升这个现象呢?
其实js和其他语言一样,都要经历编译和执行阶段。而js在编译阶段的时候,会搜集所有的变量声明并且提前声明变量,而其他的语句都不会改变他们的顺序,因此,在编译阶段的时候,第一步就已经执行了,而第二步则是在执行阶段执行到该语句的时候才执行。
总结
1.js会将变量的声明提升到js顶部执行,因此对于这种语句:var a = 2;其实上js会将其分为var a;和a = 2;两部分,并且将var a这一步提升到顶部执行。
2.变量提升的本质其实是由于js引擎在编译的时候,就将所有的变量声明了,因此在执行的时候,所有的变量都已经完成声明。
3.当有多个同名变量声明的时候,函数声明会覆盖其他的声明。如果有多个函数声明,则是由最后的一个函数声明覆盖之前所有的声明。
————————————————
版权声明:本文为CSDN博主qq_45272690的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
蓝蓝设计( www.lanlanwork.com )是一家专注而深入的界面设计公司,为期望卓越的国内外企业提供卓越的UI界面设计、BS界面设计 、 cs界面设计 、 ipad界面设计 、 包装设计 、 图标定制 、 用户体验 、交互设计、 网站建设 、平面设计服务
蓝蓝设计的小编 http://www.lanlanwork.com